#从 Harness VLA 看起:把 Agent 引入具身任务的研究全景(2022–2026)
#0. 一句话核心结论
"把 Agent 引入具身任务"这条线的本质,是把机器人系统的"认知责任"从单一 VLA 模型里拆出来,重新分配给一个分层的闭环系统——Agent 负责"做什么",Harness 负责"怎么管",VLA 只负责"手上那一下"——而 2026 年最新的进展(Harness VLA、Zetta、SHAPER 等)表明:当 VLA 冻结不动时,围绕它的工程层本身可以成为学习对象,甚至自我演化。
这背后是一个更深的判断:端到端 VLA 模型和 LLM coding agent 各自撞墙的地方恰好互补。VLA 在"接触丰富的局部操作"(抓不规则物体、精确插入)上强得惊人,但换个说法、换个布局就崩;LLM agent 推理和组合能力强,但让它直接输出关节力矩等于让律师去做外科手术。Harness VLA 这类工作做的事情,就是给两者划清楚责任边界,然后用一套带记忆、带验证、带重试的运行时(harness)把它们焊在一起。
#1. 为什么这个问题重要:两个范式的"责任错配"
先说人话版的困境。
端到端 VLA 模型(Vision-Language-Action,输入图像和指令、直接输出机器人动作的模型)这几年进步飞快:RT-2、OpenVLA、π0/π0.5、GR00T、Gemini Robotics……它们的核心能力是局部的、视觉条件的接触控制——抓一个形状奇怪的杯子、把东西插进紧配合的孔里、拧水龙头。这些恰恰是传统控制器写不出来的东西。
但 VLA 有一个结构性弱点:它只会做训练数据分布内的事。Harness VLA 论文里有个很直观的数字:让最强的 VLA 直接在 LIBERO-Pro(对标准 LIBERO 做了指令改向、位置交换等扰动)上跑,π0 基本归零(总体 0.3%),π0.5 也只有 11.0%。模型不是不会抓牛奶盒,而是当指令说"放到红色碗里"而场景布局变了之后,它会固执地重复训练时见过的行为。单一策略被迫同时消化语言 grounding、长程组合和低级控制,每一层误差都会在 rollout 里累积。
LLM coding agent(写代码调用感知/控制 API 的智能体)正好相反。Code as Policies、ProgPrompt 这条线证明了语言模型的组合泛化能力可以变成可执行程序,语义改向、目标重绑定对它来说不是问题。但纯解析式原语(IK 移动、腕部旋转、夹爪开合)在非规则抓取、受限放置、铰接物体操作上彻底没辙——这些必须靠学习的 visuomotor 能力。
每条路线都把责任分给了错误的组件。这就是这个方向存在的理由:不是"给机器人加个大脑"的浪漫叙事,而是一个很具体的架构问题——语言 grounding、长程规划、接触控制,这三件事应该由谁负责、怎么协调、失败了怎么恢复。
#2. 发展脉络:四个阶段
#阶段一(2022–2023):LLM 当规划器,机器人是"API 集合"
代表工作:SayCan(2022.4)、Inner Monologue(2022.7)、Code as Policies(2022.9)、ProgPrompt(2022.9)
这一阶段的直觉很朴素:GPT-3/4 已经懂世界知识了,能不能让它来"指挥"机器人?SayCan 的做法是让 LLM 给候选技能打"语义有用性"分,再用学到的 affordance 模型打"物理可行性"分,两个分数相乘选技能——这第一次把"语言模型懂什么"和"机器人会什么"分成了两个量,是整条线的概念起点。Inner Monologue 则把环境反馈、成功检测、人类反馈塞回规划循环,把开环规划变成了闭环推理。Code as Policies 更进一步:让 LLM 直接写可执行的策略代码,组合感知和控制 API。
留下的问题:技能库是手工设计的,接触丰富的操作(抓、插、拧)全靠底层控制器,根本做不了;反馈信号粗糙;没有从经验里学习的机制。
#阶段二(2023–2024):VLA 基础模型崛起,"技能"变成学出来的
代表工作:RT-2、Open X-Embodiment / RT-X(2023.10)、Octo(2024.5)、OpenVLA、π0(2024.10)、π0.5(2025.4)
大规模跨机构机器人数据 + VLM 底座 + 动作头,这条路把"技能"从手写 API 变成了从轨迹数据里学出来的通才策略。Open X-Embodiment 证明了跨本体迁移可行,π0 用 flow matching 把高频连续动作生成做通,π0.5 加上异构数据协同训练走向开放世界泛化。
接触控制的难题基本被这条线解决了,但它同时把阶段一留下的问题放大:现在的"技能"是一整块端到端策略,语言理解和长程组合也被压进了同一组权重里——恰恰是 VLA 最弱的部分。与此同时,另一批人开始用 LLM 在训练侧当 agent:Eureka(2023.6)让 LLM 写奖励函数、Agentic Skill Discovery(2024.5)让 LLM+RL+视觉验证器自主发现技能、RoboCat 用自主 rollout 数据持续微调通才策略——"agent 帮 agent 训练"的雏形在这里出现。
#阶段三(2025):给 VLA 套上 agent 外壳
代表工作:Agentic Robot(2025.5)、Hi Robot(2025.2)、Gemini Robotics 1.5(2025.10)、MemoryVLA(2025.8)、FailSafe-VLM(2025.10)
这一阶段的主流配方是分层:上层 VLM/LLM agent 做任务分解和监控,下层 VLA 执行。Hi Robot 把开放式指令分解成语义子目标再交给低层 VLA;Agentic Robot 提出 Plan-Execute-Verify 闭环,用"标准化动作流程"(SAP,模仿人类组织的 SOP)协调规划、执行、验证三个组件;Gemini Robotics 1.5 在工业规模上把通才策略和具身推理、显式思考结合。同时,配套能力开始专门化:记忆(MemoryVLA 把感知记忆和认知记忆集成进 VLA)、失败检测与恢复(FailSafe-VLM 用 VLM 推理失败原因并给恢复策略)。
留下的问题:这些系统证明了"agent 包 VLA"能跑,但编排方式高度工程化、一家一个做法,没有统一的设计原则;而且 agent 层基本是静态的——部署后不学习。
#阶段四(2026):Harness 本身成为研究对象,并开始自我演化
代表工作:Harness VLA(2026.7)、VLAs-as-Tools(2026.5)、ETA(2026.8)、Hi-VLA 系统研究(2026.6)、ART(2026.8)、τ0-VLA(2026.8)、Zetta(2026.8)、SHAPER(2026.8)
2026 年这条线发生了两个关键转变:
- 从"套个 agent"变成"设计运行时契约"。Harness VLA、ETA、VLAs-as-Tools 不再满足于"LLM 在上面规划",而是像软件工程里的 SWE-agent/OpenHands 那样,认真设计原语接口、执行循环、记忆读写、验证和预算策略——harness 成为一等公民的研究对象。
- 从"固定 harness"变成"演化 harness"。Zetta、SHAPER、ASPIRE 这批工作让系统在部署后持续改进自己的技能库、恢复策略、运行时 critic——冻结的 VLA 不动,harness 在进化。
#3. 锚点工作详解:Harness VLA 到底做了什么
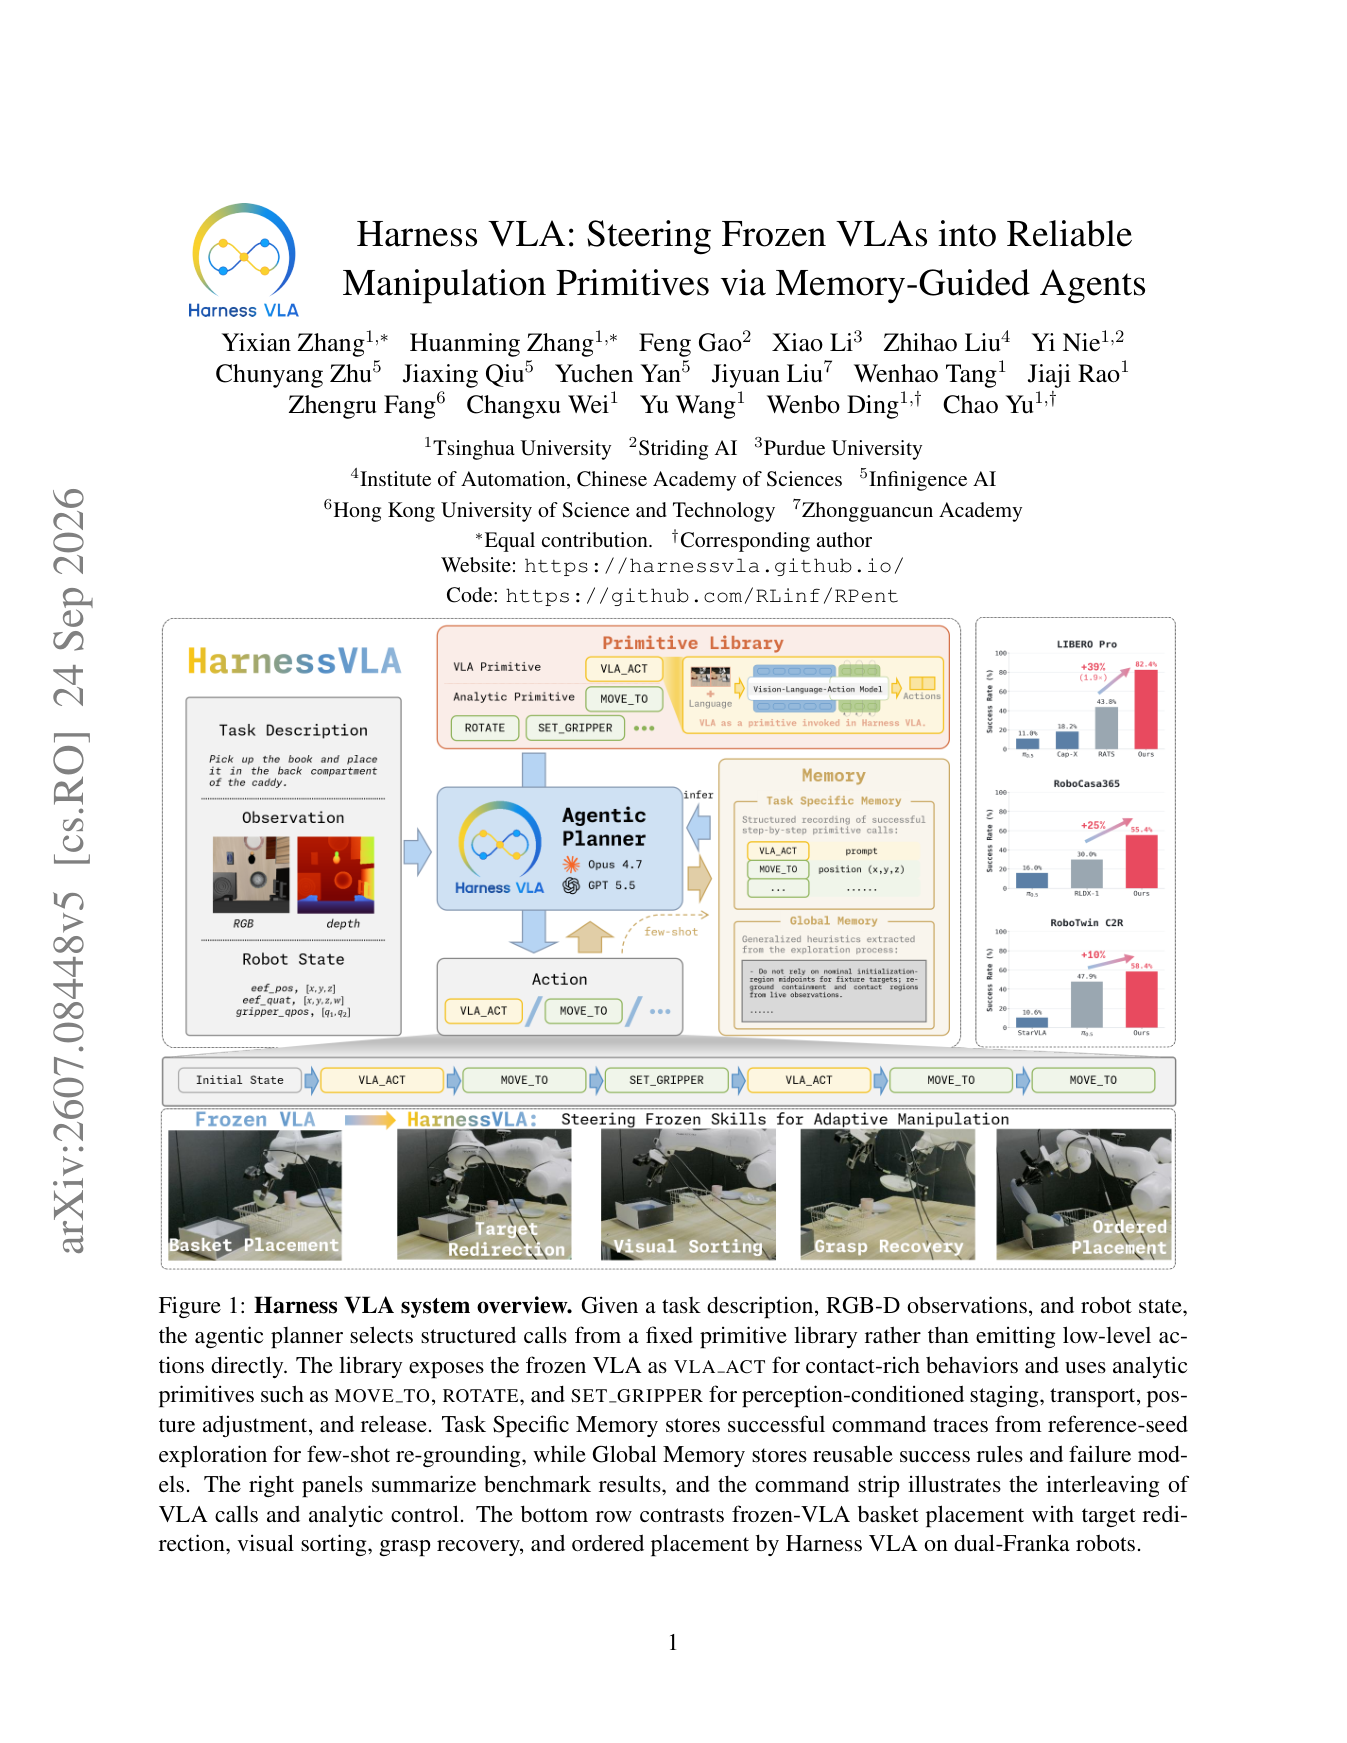
论文:Harness VLA: Steering Frozen VLAs into Reliable Manipulation Primitives via Memory-Guided Agents(arXiv:2607.08448,清华大学等,作者单位包括中关村学院;项目页 harnessvla.github.io,代码 RLinf/RPent)。
#3.1 核心思想:把冻结的 VLA 降格为"一个可重试的原语"
之前的问题:VLA 一旦部署就超出训练分布,端到端 rollout 一处失败全线崩盘;而 coding agent 路线只会扩充技能库,解析原语做不了接触操作。
它的做法:一个反直觉的降维——不扩展技能库,反而把库锁死到极小:6 个解析原语(MOVE_TO、MOVE_POSE、ROTATE_WRIST、ROTATE_PITCH、SET_GRIPPER、RELEASE)+ 1 个特殊的 VLA 原语 VLA_ACT(厨房场景再加 2 个移动底盘原语)。Planner 每轮以 JSON 形式发出一个原语调用,物理引擎执行到该原语的后置条件为止,然后返回新观测——一个 REPL 式的回合循环。
分工非常清晰:
- 解析原语负责非接触结构:目标 grounding、自由空间运输、姿态调整、re-staging、释放;
- VLA_ACT 只在局部接触丰富的区域被调用:抓取、受限放置、按按钮、开抽屉。Planner 给它一个任务条件化的 prompt 和一个提前返回谓词,冻结的 VLA 输出动作块直到谓词满足或预算耗尽;
- 关键在"可重试":VLA 的执行被当成一次局部尝试——planner 可以把机器人摆到有利的观测位、调用 VLA、检查接触结果、失败了重新 staging 再来一次。VLA 从"一条不可逆的轨迹策略"变成"一个可以反复调用的接触专家"。
#3.2 记忆:harness 学的是"原语的使用范围"而不是新原语
两个记忆模块:
- Task-Specific Memory:探索阶段在一个参考种子任务上自主试错,成功后把验证过的原语调用序列序列化成 JSONL,把具体空间坐标替换成符号化感知查询,使序列可以跨布局复用;
- Global Memory:从探索过程里提炼跨任务可复用的成功规则和失败模型(比如"空抓"和"假成功检测"的模式),避免后续任务重蹈覆辙。
这回答了一个重要问题:不扩展技能库,系统的进步体现在哪?——体现在学会每个固定原语的"工作范围":哪些子问题该交给解析原语、什么时候该调 VLA_ACT、失败后怎么重新 staging。
#3.3 数字:冻结同一个 VLA,提升从哪来
| 基准 | 冻结 VLA 直接跑 | Harness VLA | 最强相关基线 |
|---|---|---|---|
| 标准 LIBERO | πRLinf 95.3% | 96.0%(CC) | AtomVLA 97.0% |
| LIBERO-Pro(扰动) | πRLinf 50.0%,π0 仅 0.3% | 82.4%(CC) | RATS 43.8% |
| RoboCasa365(厨房) | RLDX-1 30.0% | 57.2%(Codex) | WorldDreamer 35.3% |
| RoboTwin C2R(双臂) | LingBot-VLA 50.4% | 58.4%(CC) | π0.5 47.9% |
几个值得注意的细节:
- 标准 LIBERO 上不降(96.0% vs 95.3%):harness 的额外结构没有伤害分布内性能——这一点很多分层系统做不到;
- zero-shot 消融很有信息量:完全不取任务记忆时,指令改向(Goal-T)还能保住 79.0%(vs few-shot 87.0%),说明语义重绑定主要靠 planner 在线推理;但位置交换(Goal-S)从 87.0% 掉到 31.0%——空间扰动严重依赖探索阶段发现的原语组织,任务记忆的泛化边界清清楚楚摆在这里;
- planner 用的就是 Codex 和 Claude Code 这类现成 coding agent(附录还测了 GPT-6 Astra),说明核心竞争力在 harness 设计而不是自训模型。
#3.4 它自己承认的局限
论文结论部分难得地坦诚:planner 和 VLA 之间是开环反馈(VLA 执行期间 agent 无法介入);没有联合微调(未来需要 GRPO 这类样本高效的 RL);复杂长程任务里缺少细粒度图像描述能力。这些局限恰好是下一节自进化方向的机会。
#4. 代表工作演化链:每个工作解决了什么、留下了什么
按"问题链"组织(每项:之前的问题 → 方法 → 新问题 → 如何推动下一阶段):
#4.1 SayCan(2022.4)— 一切的起点
- 之前的问题:LLM 有世界知识但输出不可执行;机器人有技能但不懂语言。
- 方法:语义有用性 × 物理可行性双打分,选技能。
- 新问题:技能库手工设计、覆盖有限;规划开环。
- 推动:确立了"语言知识和物理能力分开建模再组合"的基本范式。
#4.2 Inner Monologue(2022.7)/ Code as Policies(2022.9)
- 之前的问题:开环规划,环境一变计划就废。
- 方法:把环境反馈/成功信号塞回规划循环;或让 LLM 写可执行策略代码。
- 新问题:底层全是解析控制器,接触操作做不了;反馈信号粗糙。
- 推动:闭环执行和"代码即策略"两个思想,都被后来的 harness 直接继承。
#4.3 π0 / π0.5(2024.10 / 2025.4)— 接触控制被解决
- 之前的问题:VLA 动作生成粗糙、跨场景泛化差。
- 方法:flow matching 高频连续控制;π0.5 加异构数据协同训练和语义知识注入。
- 新问题:长程组合和指令遵循仍是短板(LIBERO-Pro 上近乎归零)。
- 推动:提供了"值得被包装"的强 VLA 底座——没有强底座,harness 就无从谈起。
#4.4 Hi Robot(2025.2)/ Agentic Robot(2025.5)— 分层成为默认架构
- 之前的问题:单一 VLA 无法处理开放式指令和长程任务。
- 方法:VLM 规划器产出语义子目标,VLA 执行;Agentic Robot 加 Plan-Execute-Verify 闭环和 SOP 式协调协议。
- 新问题:各家编排方式随意,无设计原则;执行中错误累积、验证机制弱。
- 推动:把"agent 层"确立为系统必需组件,为系统化研究铺路。
#4.5 VLAs-as-Tools(2026.5)— VLA 正式成为"工具"
- 之前的问题:分层系统里 agent 和 VLA 的接口含糊,agent 得持续轮询监控。
- 方法:把一组专门化 VLA 暴露成带进度反馈的工具,VLM agent 做时间推理,事件触发的重规划(不用持续轮询);再加工具对齐的后训练。
- 新问题:工具库从哪来、每个工具的可靠边界在哪,仍未回答。
- 推动:"VLA 即工具"的接口化视角,与 Harness VLA 互为印证。
#4.6 Harness VLA(2026.7)— 冻结 VLA + 极小固定原语库 + 记忆
- (详见第 3 节。)
- 推动:证明了 harness 工程本身可以带来数十个百分点的提升,且不动 VLA 权重——把研究重心从"训更强的策略"转向"管好现有策略"。
#4.7 ETA(2026.8)与 Hi-VLA 系统研究(2026.6)— 从系统到科学
- ETA:Planner–Interface–World 的极简三元组,一次一个工具调用,开源 OpenETA——主张"可迁移的编排"而非"更大的单体策略"。
- Hi-VLA 系统研究:把代表性分层 VLA agent 统一到 options 式控制框架下,系统消融 planner 选择、接口设计、观测与记忆表示对短程/长程/推理密集任务的影响——分层 agent 领域第一次有了受控实验的设计原则。
- 推动:从"做出一个能跑的系统"转向"知道为什么这样设计"。
#4.8 ART(2026.8)— 反向路线:把工具注进 VLA 内部
- 之前的问题:外挂 harness 的 VLA 在工具调用处仍要中断连续动作生成。
- 方法:训练 VLA 在端到端流里即时调用现成多模态工具(低层视觉、affordance、本体增强),缩减动作解空间;仅用 30K 工具使用轨迹(远小于基线)就提升泛化、降低数据依赖。
- 和 Harness VLA 的对比:Harness VLA 把智能放在 VLA 外面的 harness;ART 把工具调用压进 VLA 权重里——外挂 vs 内化的路线之争正式成型。
#4.9 τ0-VLA(2026.8)— 测试时计算进入具身
- 之前的问题:分层 VLA 的高层决策是一次前向传播,没有"多想一会儿"的机制。
- 方法:高层策略生成子任务时,利用执行记忆和世界模型引导的测试时搜索在候选中挑选再提交;4 万小时异构真实数据多模态协同训练。
- 推动:test-time scaling 的思路进入机器人——这直接连接到推理预算分配这条更大的研究线。
#4.10 自进化一簇:Zetta / SHAPER / ASPIRE / VASO / ENPIRE(2026)
- Zetta:指出此前 harness 本质开环(rollout 时固定技能、episode 结束才反思);用三个时间尺度分离的闭环让运行时 critic 和恢复技能在线演化(动作频率治理、rollout 级提案、验证门控更新),VLA 冻结。
- SHAPER:同时演化可复用文本技能和上下文代码 harness,两阶段"先技能后 harness"搜索 + 沙箱候选 + top-k 验证。
- ASPIRE(NVIDIA):从执行轨迹做因果失败诊断、合成修复、把验证过的程序蒸馏成跨任务/跨本体可复用技能——一次性修复 vs 沉淀为技能的区分很有启发。
- VASO:对技能"合同"(前置条件、局部规则、planner 侧语义)用时序逻辑规范 + 模型检测反例来精炼——把自进化技能接到形式验证上。
- ENPIRE:更激进,coding agent 直接在真实机器人上改策略改进算法、奖励、训练基础设施、评测代码——进化的是训练代码层。
- 共同的推动:把"agent 系统部署后还能变好"变成可研究的问题,并给出分工明确的演化层级(harness/runtime、skill/library、contract/verifier、policy/data、objective/reward、memory/context)。
#5. 技术分类地图
按"改变的是哪一层"组织(对应 Agent–Harness–VLA 栈的分层视角):
| 路线 | 核心主张 | 代表工作 | 代价/权衡 |
|---|---|---|---|
| 训练侧内化 | 智能压进 VLA 权重 | ART、G0.5、τ0-VLA、Agentic-VLA(奖励合成+语言引导探索+经验记忆的在线适应) | 需要训练数据和算力;换了任务要重训 |
| 分层编排 | Agent 规划 + VLA 执行 | Hi Robot、VLAs-as-Tools、Agentic Robot、Hi-VLA | 接口设计敏感;agent 推理延迟 |
| Harness 工程 | 冻结模型 + 运行时治理 | Harness VLA、ETA、Zetta | 靠 LLM planner 的上限;跨任务记忆边界 |
| 自进化 | 部署后持续改进非参数部分 | Zetta、SHAPER、ASPIRE、VASO、ENPIRE、Uni-Skill、EmbodiSkill | 验证门控设计难;坏更新的回归风险 |
| 具身记忆 | 跨时间的状态保持 | MemoryVLA、AtlasVLA、MEMORA、MemER、MEM(π)、3D-Mem、DynaMem | 记什么、怎么固化、怎么遗忘都开放 |
| 世界模型/WAM | 想象未来辅助决策 | τ0-WM、V-JEPA 2、WAM 综述、ST-WAM、Fast-WAM | 想象的可靠性/接地问题;推理成本 |
| 验证与安全 | 过程级检查与约束 | Pre-VLA、SafeRelBench、MANIGUARD、AHA、CycleVLA、FPC-VLA | 规范从哪来;误报/漏报权衡 |
| 基准 | 逼出鲁棒性 | LIBERO-Pro、RoboCasa365、RoboTwin C2R、Open X-Embodiment | 仿真扰动 vs 真实物理差距 |
一个观察:这张表里的路线不是竞争关系,而是可以叠加的正交维度——Harness VLA(编排)+ 记忆 + 验证 + 自进化,大概率是未来系统的标配组合。真正悬而未决的是路线之间的接口。
#6. 当前瓶颈与开放问题
(1)planner–VLA 的开环反馈断层。 Harness VLA 自己承认:VLA 执行接触动作期间,agent 是"盲"的,无法以物理频率介入。Zetta 的整个出发点就是大模型 agent 的决策频率跟不上物理交互频率。认知层和控制层之间的时间尺度鸿沟是这个方向最基础的未解问题——这本质上是连续控制与离散符号决策的接口问题。
(2)harness 知识无法回流到权重。 任务记忆(JSONL 轨迹)、失败模型、成功规则都是非参数的、任务级的。它们不能迁移到没有探索过的任务上(Goal-S 从 87% 掉到 31% 就是证据),也不能改进 VLA 本身的分布内能力。"运行时学到的知识如何蒸馏回基础模型"——这是 agent 轨迹数据能否成为持续预训练语料的关键问题。
(3)探索的性价比与记忆的泛化边界。 每个任务在一个参考种子上 bootstrap,本质上还是任务级的少量学习。什么扰动靠通用 planner 推理就能扛住(指令改向:79%)、什么必须靠探索记忆(位置交换:31%),Harness VLA 的消融第一次把这个边界量化出来——但边界为什么会画在那里、如何把"需要记忆的部分"压到最小,完全没人知道。
(4)验证与安全的形式化。 VLA 安全评测正在从"最终成功率"转向"过程级违规"(SafeRelBench、MANIGUARD),但规范本身(什么算安全)来自哪里、如何在物理执行的低延迟约束下检查,仍是开放问题。VASO 的时序逻辑路线只是一个开始。
(5)评测的生态位偏差。 这条线的强结果几乎全部来自仿真(LIBERO/LIBERO-Pro、RoboCasa365、RoboTwin),真实机器人只有少量演示性实验。仿真里 RGB-D 和本体感知是完美对齐的,真机上这个假设直接碎掉。
(6)成本结构。 每个 episode 跑一个 frontier coding agent(Claude Code/Codex),token 成本和延迟都远高于策略前向传播。Zetta 用"运行时 critic"替代大模型在线决策来省成本,但"什么时候值得烧这个推理预算"本身没有理论——这正是测试时计算分配问题的具身版本。
#7. 研究判断与机会(面向 LLM Agent / model-based RL / 潜空间推理视角)
判断一:harness 是 VLA 的"上下文工程",但缺一个理论。 软件侧 agent 已经经历了"prompt 工程 → 上下文工程 → harness 工程"的演进,具身侧正在复刻这条路,而且物理世界的约束让问题更硬。现在的 harness 设计全是经验性的(Hi-VLA 系统研究开了头),一个关于"原语粒度–记忆结构–重试策略"的形式化框架会是有长期价值的贡献。
判断二:failure model + 重试是 model-based RL 在具身 agent 里的最佳切入口。 Harness VLA 的"失败模型"目前只是文本形式的规则。如果失败模型是一个学习到的、动作条件化的世界模型,agent 就可以在想象中预演重试方案(哪个 staging 姿势这次能成功),而不是在物理世界里试错。τ0-VLA 的世界模型引导搜索已经迈出一步,但它只在高层子任务粒度上搜索——把想象下推到接触阶段的重试决策,同时解决开环反馈断层,是 model-based RL 与这条线的天然交叉点。
判断三:harness 轨迹是天然的"可验证 agent 数据",指向持续预训练。 一个跑通的 harness 系统每个 episode 都在生产结构化数据:原语调用序列、观测、成败信号。这批数据比自由网页数据干净得多(有环境谓词验证),比纯 RL 轨迹便宜得多(不需要奖励模型)。"harness 产生的轨迹 → 蒸馏回 VLA 权重"的闭环(解决第 6 节问题 2)同时踩中 wenjun 关注的持续预训练和长轨迹 RL 两个方向——而且绕开了在超长轨迹上直接做 RL 的信用分配噩梦:harness 的原语边界天然把轨迹切成了有语义的分段。
判断四:任务记忆的参数化 = 潜空间推理的具身版。 Task-Specific Memory 的 JSONL 轨迹是"用文本外显的任务状态"。它换布局就失效(必须靠感知查询重新 grounding),说明这种表示没有捕获任务的决策充分状态。如果把探索得到的成功经验固化成一个潜在的、可微的任务状态表示(而不是符号轨迹),"位置交换"这类扰动或许不需要逐任务重新探索——这正好是潜空间推理研究里"decision-sufficient state compression"的具身投影。
判断五:跨层协同演化是被低估的终局问题。 自进化一簇目前都只动一层(技能、或 harness、或训练代码)。awesome-agentic-robotics 的 taxonomy 里点名的"cross-layer co-evolution"——技能库变了 harness 路由规则要不要跟着变、VLA 更新了失败模型还准不准——涉及组合爆炸的兼容性维护,是真正的难题也是真正的护城河。
#8. 给想快速入门的人:一条阅读路线
- 先读 Harness VLA(arXiv:2607.08448)建立锚点:冻结 VLA、极小原语库、记忆、可重试——这个框架能装下后面所有工作;
- 往回读 SayCan → Inner Monologue → Code as Policies,理解范式起点;
- 读 Hi-VLA 系统研究(2606.10267)获得设计原则的分类语言;
- 读 Zetta(2608.16590)和 SHAPER(2608.11350)看自进化 harness 的两种实现哲学;
- 读 τ0-VLA(2608.16885)和 WAM 综述(2605.12090)接上世界模型线;
- 用 awesome-agentic-robotics(github.com/w-xb/awesome-agentic-robotics)的 Agent–Harness–VLA taxonomy 做地图补全。
参考与资源:Harness VLA(arXiv:2607.08448,代码 github.com/RLinf/RPent,项目页 harnessvla.github.io);Awesome Agentic Robotics(github.com/w-xb/awesome-agentic-robotics,2026-09 更新);各代表工作见文中 arXiv 编号。本文图片取自 Harness VLA 论文(arXiv:2607.08448v5)。