#On-Policy Distillation(OPD)进展综述:大模型教小模型的「第三条路」
本文只关注一个设定:一个强的大模型当 teacher(老师),一个小模型当 student(学生),把大模型的能力高效地「压」进小模型。至于 self-distillation(模型教自己)、同规模互相蒸馏等工作不在本文主线,只在需要说明演化逻辑时顺带提到。
阅读前提:只需知道「训练后模型」这个概念(pre-train → post-train),不需要 RL 基础。
#1. 一句话讲清楚 OPD
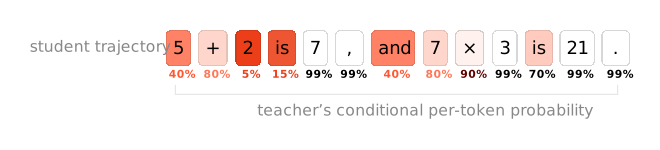
让小模型自己写作业(生成回答),让大模型逐字批改(对每个 token 给出「应该是什么概率分布」),小模型根据批改意见改进。
对比另外两条路:
| 路线 | 类比 | 信号形式 | 主要问题 |
|---|---|---|---|
| SFT(off-policy 蒸馏) | 抄大模型的优秀范文集 | 每题一份标准答案 | 答案不是小模型自己写的,训练/推理分布不匹配;小模型学不会「自己犯错后怎么改」 |
| RL(RLVR) | 只告诉你对/错 | 每条轨迹一个 0/1 奖励 | 信号太稀疏,只知道「错了」不知道「错在哪一步」,计算代价极高 |
| OPD | 学生做题 + 老师逐字批改 | 每个 token 一个 dense 信号 | 需要额外跑 teacher 算 log-prob,但批改可以高度并行 |
OPD 的核心洞察是:RL 太稀疏,SFT 太 off-policy,而「在学生自己的轨迹上,用 teacher 的 token 级分布做监督」同时拿到了 on-policy 和 dense 两个好处。Thinking Machines Lab 2025 年 10 月的博客把这个 recipe 推广开来(Qwen3-32B → Qwen3-8B-Base,AIME'24 达 70%,计算成本相比 SFT 管线降低 9–30×,GPU 小时约 18×),社区随后在 2026 年爆发式跟进。
#2. 发展脉络
#阶段一(2023):概念雏形——「在学生自己的数据上蒸馏」
- GKD(Generalized Knowledge Distillation, 2306.13649,Google, 2023.06):第一个系统提出「用 student 自生成序列 + teacher 反馈」解决训练-推理分布不匹配的工作。提出了 GKD 损失 = 数据分布 × 散度类型(forward/reverse KL/JSD)的二维设计空间。
* 解决了什么:SFT 式蒸馏的分布偏移。
* 暴露了什么:散度选择全靠手调;reverse KL 的采样方差问题未解。
- MiniLLM(2306.08543,清华/智谱, 2023.06):明确「白盒大 LLM → 小 LLM」设定,把蒸馏目标换成 reverse KLD(mode-seeking,防止小模型在 teacher 低概率区域乱生成),并给出单步策略梯度优化。
* 意义:确立了「大模型→小模型用 reverse KL」这条主线。
* 暴露了什么:方差大、训练不稳。
- DistiLLM(2402.03898,KAIST, 2024.02):skew KL + 毕业生(multi-scale students)机制,让 OPD 更稳更省。
* 解决了什么:reverse KL 的方差与成本问题。
* 暴露了什么:仍是「蒸馏」视角,还没和 RL 理论接轨。
这一阶段的关键词:分布不匹配(distribution mismatch)。蒸馏还是「知识压缩」叙事,OPD 只是修正项。
#阶段二(2025):范式确立——「OPD = RL 的稠密信号替代品」
转折点是 Thinking Machines Lab 的 On-Policy Distillation 博客(2025.10):
- 机制:student rollout → teacher 对 student 轨迹算 reverse KL → 把 per-token negative reverse KL 当作 advantage,用 RL 的 loss(如 GRPO/PPO 风格)更新 student。
- 这一步的深层意义:把蒸馏和 RL 统一了——蒸馏不再是「模仿」,而是「用 teacher 分布替代环境奖励的 RL」。dense 信号让每个 token 都有梯度,训练效率远超稀疏奖励 RL。
- 数据(Qwen3-32B → Qwen3-8B-Base,AIME'24):
| 方法 | AIME'24 | 相对 SFT-2M 计算效率 |
|---|---|---|
| SFT-400K | 60% | – |
| SFT-2M(外推) | ~70% | 1× |
| RL(Qwen 技术报) | 68% | ≈1× |
| OPD | 70% | 9–30× |
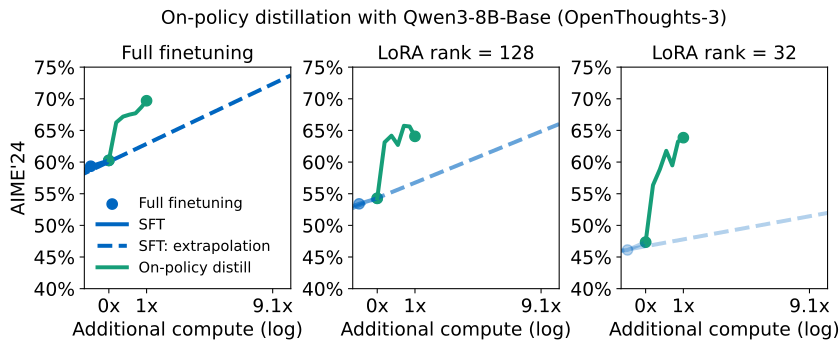
这一阶段的关键词:dense supervision(稠密监督)。OPD 从「蒸馏技巧」升格为「后训练范式」,与 SFT、RLVR 并列。
#阶段三(2026 上半年):机制拷问——「teacher 信号到底教了什么?」
范式火了之后,2026 年的一批工作开始拆解它的黑盒:
- Does OPD Really Distill?(2608.31046):发现 teacher 对 student 轨迹打分时噪声很大,且噪声随 teacher 规模增大而增加;但 student 对噪声不敏感,最终收敛到「self-improvement」——你以为是老师在教,其实是学生在自我改进。这篇直接动摇了「OPD = 知识转移」的直觉。
- What Matters in OPD? / Rethinking OPD II / Data-free OPD(2609.05198 / 2609.04172 / 2609.14193):三条独立证据链指向同一结论——OPD 对训练数据近乎无感:8 个 prompt 就能追平 17k 题库;单条训练几百步能恢复全量数据的大部分收益;不同数据集的训练曲线几乎不可区分。原因:OPD 的「数据单位」是 prompt 引导出的 state(状态) 而非 prompt 本身,on-policy 训练天然覆盖大量状态。
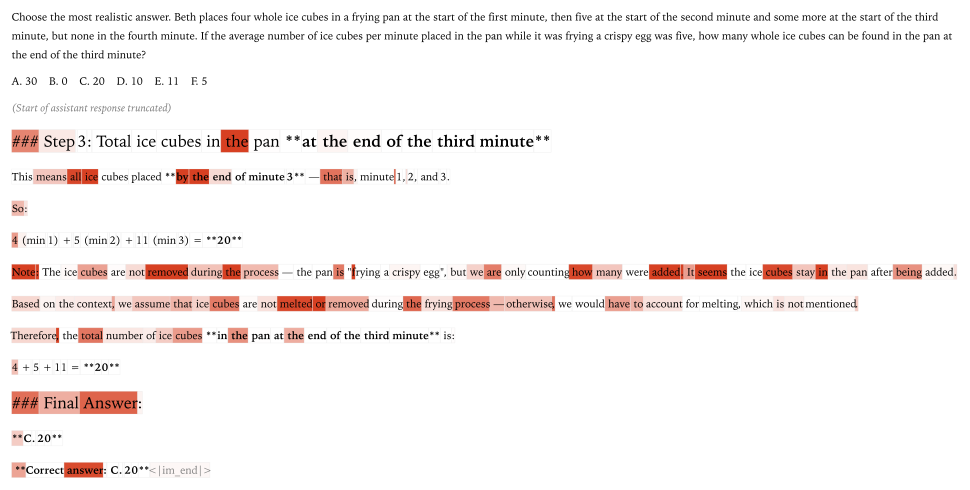
- When EOS Tokens Disagree(2609.20511):一个精致的失败案例——base student 和 post-trained teacher 把「停止」概率放在不同的 EOS token 上,导致 student 回答越来越长(length inflation),对齐 decoding 的 stop set 都不够,必须把功能等价的 EOS token 视为同一动作。
- CompassOPD(2609.10154):跨模型家族蒸馏几乎失效——强外部 teacher 带来的提升有限,OPD 的增益主要来自「同家族内 likelihood shift」。
- Calibrating Teacher–Student Discrepancy(2609.21619):teacher 自身的偏差(不只是能力差)会混进 OPD 信号被 student 一并学走,需要校准。
这一阶段的关键词:信号可靠性(teacher noise / bias / gating)。社区意识到 teacher 不是完人,「要不要听、听多少、听谁的」成了新战场。
#阶段四(2026 下半年,进行中):精细化工程——「哪里听、听谁的、何时停」
当前最活跃的四个子方向(全部 2026.08–09 的新论文):
(a) Token 级选择性监督(sparse OPD)
- 1% of Tokens Can Be Enough(2609.24432):提出信息效率比 IER(信噪分解 + 最优标量基线),据此挑选 <1% 的 token 做 teacher 监督就够。数学/迷宫基准上效果保留。
- Who Teaches Which Token?(VG-OPD, 2609.15404):多专家 teacher 场景下,用 verifier 的反事实增益决定「哪个专家教哪个 token」。
- TrustMOPD(2609.23697):无标签、token 级的 teacher 可靠性分配,用「RL 引起的位移」当可靠性代理。
- TV-Regulated OPD(2609.08341)、Distillation as Probability Transport(2609.08337):更精细的梯度方向控制。
(b) Teacher 门控与校准
- Verify Before You Distill(2609.02998):reverse KL 是 mode-seeking,自信但错误的 teacher 会造成强烈误导——先验证 teacher 在该 prompt 上能否做对,再决定是否蒸馏。
- Teacher Should Think Ahead(2609.22254):发现 Teacher Uncertainty Contraction——teacher 从 student 前缀继续生成时,不确定性会系统性下降;让 teacher 先「想一想」再打分更可靠,但有 variance-bias 权衡。
- Trajectory Learnability(2609.18321):offline OPD 中 teacher 失败 ≠ 全轨迹不可学,用 teacher 做对的题定义可学性度量。
(c) 与 RL 的组合配方
- Sequential Beats Joint(2609.04108):两阶段 OPD → RLVR 简单组合,稳定优于纯 OPD、纯 RLVR 及所有加权融合/teacher 调制 baseline。
- RetireOPD(2609.20784):agent RL 场景,teacher 监督的收益是分阶段的——训练后期自动「退休」teacher,退回纯 RL。
- γOPD(2609.16937):建立 token 级 vs 序列级 OPD 的统一时序视角(token 级 = 序列级 reverse KL 梯度的时序近似),用折扣回报做 credit assignment 平衡两者。
(d) 计算效率与多轮 agent 场景
- CLOOPD(2609.24141):闭环框架,把「teacher 信号获取」和「student 消化」解耦,冻结果 advantage 多次 actor pass 复用。
- Know When to Stop, Where to Restart(2609.14636):多轮 agentic OPD 中监督信号集中在轨迹前缀,按可靠性截断/重启可大幅加速。
- 低比特 OPD(2609.26708):把 OPD 用于量化 student 的「训练-推理一致性」——在量化模型会去的地方训练。
- 多模态/领域扩展:OPD-Aha(2609.16459,视觉反思)、iSDFT(2609.24646,持续学习)、医疗 OPVD、语音 Joint-Output OPD 等大量领域移植。
#3. 技术机制拆解(人话版)
#3.1 损失函数为什么是 reverse KL
设 student 在自己轨迹上位置 t 的分布是 ,teacher 给出 :
- forward KL(SFT 式): —— 老师「拍着学生的头」往自己的模式上带,学生必须覆盖老师的所有模式,容易在老师也没把握的地方乱学(mass-covering)。
- reverse KL(OPD 式): —— 只在学生自己走到的地方要求贴近老师(mode-seeking),老师高概率学生低概率的地方才会被强拉,学生已对的地方不动。这就是「批改作业」:只改你写错的地方。
#3.2 和 RL 的统一视角
OPD 的损失可以写成「per-token advantage = −reverse KL,然后套 RL 的 policy-gradient loss」。这等价于把 teacher 分布当成「每一步都有奖励的环境」。这就是为什么 OPD 能用 GRPO/PPO 式的训练栈直接跑:teacher 是一个每个 token 都给反馈的密集奖励环境。
- RL 每条轨迹只给 1 个 bit(对/错);
- OPD 每个 token 给一个连续信号(分布差);
- 所以同样到达 70% AIME,OPD 的 prompt 数量只要 RL 的零头(数据效率 8× 以上),GPU 小时少 18×(teacher log-prob 计算高度可并行)。
#3.3 2026 年新发现的三个坑
- teacher 噪声:teacher 在 student 前缀上打分本来就 off-policy(对 teacher 而言),越大越自信的 teacher 噪声反而越大——但 student 似乎天然滤噪。
- 数据悖论:OPD 几乎不在乎用什么题库(8 条 vs 17k 条差不多),因为真正被训练的是「student 访问过的状态」,prompt 只是造状态的种子。
- 终止行为漂移:EOS token 概率分布不同会导致学生停不下来、回答膨胀,这是分布匹配目标完全没考虑到的「行为层」副作用。
#4. 代表工作速览表(大 teacher → 小 student 主线)
| 工作 | arXiv | 时间 | 核心贡献 | 一句话 |
|---|---|---|---|---|
| GKD | 2306.13649 | 2023.06 | 首次系统化 student 自生成蒸馏 | OPD 概念的起点 |
| MiniLLM | 2306.08543 | 2023.06 | reverse KLD + 策略梯度 | 大→小 LLM 蒸馏基线 |
| DistiLLM | 2402.03898 | 2024.02 | skew KL + multi-scale student | 更稳更省的蒸馏框架 |
| Thinking Machines 博客 | – | 2025.10 | per-token −RKL 作 advantage | 范式确立,9–30× 计算效率 |
| Does OPD Really Distill? | 2608.31046 | 2026.08 | teacher 噪声分析 | 增益可能来自 self-improvement |
| Sequential Beats Joint | 2609.04108 | 2026.09 | OPD→RLVR 两阶段 | 简单组合打败花式融合 |
| Data-free OPD | 2609.14193 | 2026.09 | 8 prompts ≈ 17k 数据集 | OPD 对数据近乎无感 |
| Verify Before You Distill | 2609.02998 | 2026.09 | prompt 级 teacher 门控 | 自信的老师更危险 |
| 1% of Tokens | 2609.24432 | 2026.09 | IER token 选择 | 监督可以稀疏到 1% |
| VG-OPD / TrustMOPD | 2609.15404 / 2609.23697 | 2026.09 | token 级多 teacher 分配 | 谁教哪个 token |
| CompassOPD | 2609.10154 | 2026.09 | 跨家族分解 | 跨家族蒸馏近乎失效 |
| γOPD | 2609.16937 | 2026.09 | 统一时序 credit assignment | token 级 vs 序列级统一 |
| RetireOPD | 2609.20784 | 2026.09 | agent RL 中分阶段退役 teacher | agentic OPD 配方 |
| CLOOPD | 2609.24141 | 2026.09 | 信号获取/消化解耦 | 闭环复用 teacher 信号 |
| EOS Disagree | 2609.20511 | 2026.09 | length inflation 机制 | 终止 token 也要对齐 |
| 低比特 OPD | 2609.26708 | 2026.09 | 量化 student 的 OPD | 训练-部署一致性 |
#5. 研究判断与开放问题
我的判断(基于 2026.09 的文献状态):
- OPD 已经不是「蒸馏」,而是「用 teacher 做密集奖励函数的 RL」。这条统一视角(reverse-KL-as-advantage)解释了它为什么能进 RL 训练栈、为什么数据效率高、也预示了它会继承 RL 的所有老问题(探索、稳定性、奖励 hacking——这里对应 teacher bias)。
- 「大模型 → 小模型」的增益边界正在被摸清:跨家族几乎无效、数据无关、teacher 噪声随规模增大——这三条证据合起来指向一个有点反直觉的图景:OPD 的增益可能主要不是「知识搬运」,而是「把 teacher 的分布当作塑形信号,引导 student 在自己的状态空间里快速收敛」。真正被转移的是行为分布的形状,不是知识内容。
- 工程重心已从「设计更花的损失」转向「决定在哪里施加监督」:token 选择、teacher 门控、阶段调度(何时开始、何时退休 teacher)、prompt 覆盖——都是「稀疏化 + 调度」问题。这与 RL 中 credit assignment 的经典难题同构。
开放问题(适合作为研究方向):
- OPD 的增益本质:如果 student 对 teacher 噪声不敏感、数据无关,那 teacher 到底提供了什么?是不是只提供了一个「更容易优化的稠密优化景观」?能否用机制可解释性工具直接观测「什么被转移了」?
- 跨能力蒸馏:推理能力好蒸(有明确的 token 级对错结构),长程 agentic 能力(多轮工具调用、credit assignment 跨越数百 token)能否用同一配方?RetireOPD 只给了初步答案。
- 与 model-based RL 的接口:teacher 本质上是一个「一步预测的世界模型/价值先验」。如果把 OPD 中的 teacher 从「正确答案先知」换成「学出来的世界模型」,就得到一条通往 model-based post-training 的路径——小 model 用自己维护的 world model 做 dense 监督,这可能是不依赖大 teacher 的 OPD 的下一代形态。
- 理论缺口:为什么 student 对 teacher 噪声鲁棒?1-shot OPD 为什么几百步持续提升?state coverage 的刻画还停留在实证。
- 多 teacher 路由的 scaling law:多专家 token 级路由(VG-OPD/TrustMOPD)的收益随专家数怎么 scaling?
#6. 参考文献与链接
- Thinking Machines Lab, On-Policy Distillation(2025.10): https://thinkingmachines.ai/blog/on-policy-distillation/
- GKD: https://arxiv.org/abs/2306.13649
- MiniLLM: https://arxiv.org/abs/2306.08543
- DistiLLM: https://arxiv.org/abs/2402.03898
- Does OPD Really Distill?: https://arxiv.org/abs/2608.31046
- What Matters in OPD: https://arxiv.org/abs/2609.05198
- Rethinking OPD II: https://arxiv.org/abs/2609.04172
- Data-free OPD: https://arxiv.org/abs/2609.14193
- Sequential Beats Joint: https://arxiv.org/abs/2609.04108
- Verify Before You Distill: https://arxiv.org/abs/2609.02998
- Teacher Should Think Ahead: https://arxiv.org/abs/2609.22254
- 1% of Tokens Can Be Enough: https://arxiv.org/abs/2609.24432
- VG-OPD: https://arxiv.org/abs/2609.15404
- TrustMOPD: https://arxiv.org/abs/2609.23697
- CompassOPD: https://arxiv.org/abs/2609.10154
- γOPD: https://arxiv.org/abs/2609.16937
- RetireOPD: https://arxiv.org/abs/2609.20784
- CLOOPD: https://arxiv.org/abs/2609.24141
- When EOS Tokens Disagree: https://arxiv.org/abs/2609.20511
- Trajectory Learnability: https://arxiv.org/abs/2609.18321
- Calibrating Teacher–Student Discrepancy: https://arxiv.org/abs/2609.21619
- Train Where the Quantized Model Goes: https://arxiv.org/abs/2609.26708
- Know When to Stop: https://arxiv.org/abs/2609.14636
(本文调研时间:2026-09-25;检索源:arXiv、OpenAlex、Thinking Machines 博客;聚焦「大 teacher → 小 student」设定的 LLM 工作为主。)