#LLM/VLM 规划器 + 技能库:具身智能的"会指挥不会干活"流派
#0. 一句话核心论点
这条流派的核心主张是:语言模型不该直接输出低级动作(关节角、末端位姿序列),而应该充当"大脑",从一个人工预先定义好的技能库里挑选、组合、参数化技能,实际的"动手"交给技能库里的底层策略去干。
用一句话概括这条路线的世界观:
LLM 知道"该做什么",但不知道"现在能不能做";底层策略知道"怎么动手",但不知道"用户想要什么"。把两者接起来,就能得到一个既能听懂人话、又不会瞎动的机器人。
这条路线崛起于 2022-2023 年(恰好是大模型能力爆发、但 VLA 端到端模型还没成熟的窗口期),六个代表作的演化逻辑非常清晰:
| 论文 | 时间 | 核心一句话 | 它解决的新问题 |
|---|---|---|---|
| SayCan (Google) | 2022.04 | LLM 打分 × affordance 打分,选出当前真能执行的技能 | LLM 选出的动作机器人未必做得动 |
| ProgPrompt (NVIDIA) | 2022.09 | 用 Python 程序当 prompt,让 LLM 生成的计划天然可执行 | 自由文本计划里混着做不了的动作 |
| Inner Monologue (Google) | 2022.07 | 把执行结果/场景变化变成文本反馈给 LLM,闭环重规划 | 开环计划一出错就一路错到底 |
| Code as Policies (Google) | 2022.09 | LLM 直接生成调用机器人 API 的 Python 代码 | 从"选技能"升级为"写控制逻辑" |
| Instruct2Act (上海AI Lab) | 2023.05 | LLM 生成代码调用 SAM/CLIP 等视觉基础模型 API | 感知端也要开放词汇、模块化 |
| VoxPoser (Stanford) | 2023.07 | LLM 生成代码合成 3D value map,替代预定义技能 | 技能库里没有的动作怎么办 |
注意时间线有个细节:Inner Monologue(2022.07)比 ProgPrompt/CaP(2022.09)更早挂上 arXiv,但它是在 SayCan 架构上加闭环反馈,所以我按"概念演化"而不是严格时间排序来讲。下文逐篇展开。
#1. 为什么会有这条路线:LLM 的知识 vs 机器人的身体
先讲清楚这条路线要解决的根本矛盾。
2022 年时,PaLM、GPT-3 这类大语言模型已经在文本语料里"读遍天下",积累了海量常识性知识:可乐是什么、海绵能吸水、打开抽屉之前得先找到把手。这些知识对机器人极其诱人——以前要让机器人理解"我洒了水,帮我擦一下",你得专门收集一堆桌面擦桌子数据、训一个语言条件策略,换一句指令就全废。
但直接把 LLM 接到机器人上有两个致命问题:
- LLM 没见过物理世界。 它的每个 token 概率都来自文本,从没"伸手"试过、没看过动作的结果。你问它"帮我拿可乐",它能排出完美的步骤清单,但这个清单里可能包含"拿起离你三米远的那个可乐"——而机器人此刻根本够不着。它知道该做什么,但不知道机器人现在能不能做。
- LLM 输出的是 token,不是动作。 让它直接吐关节角序列,既没有训练信号也谈不上精度。
这条流派的解法很朴素:不要让 LLM 越过中间层。 在 LLM 和电机之间插一个"技能库"——每个技能是一个预训练好的策略(BC/RL 训出来,或者干脆是写好的参数化原语,比如 move_to(x,y,z)、pick(obj)),带一份自然语言描述。LLM 的工作从"输出动作"变成"在技能库里做选择和编排"。
这就把问题从"让 LLM 学会控制机器人"(几乎不可行)降维成"让 LLM 做一个合格的调度器"(大模型天然擅长)。
#2. SayCan(2022):LLM 打分 × 价值函数打分
论文:Do As I Can, Not As I Say: Grounding Language in Robotic Affordances,Google Robotics,arXiv:2204.01691,CoRL 2022。
#2.1 它想解决什么
SayCan 处理的正是上面说的第 1 个问题:LLM 的建议脱离机器人的物理现实。标题起得极好——"照我能做的做,别照我说的做"。
#2.2 方法:两个概率相乘
SayCan 的机制简洁到可以用一行公式讲完。机器人有一个技能库,每个技能 配两样东西:
- LLM 打分 :LLM 认为这个技能对完成指令有多"有用"(实现上是对每个技能的自然语言描述算 log 概率);
- Affordance 打分 :一个语言条件的价值函数,衡量从当前状态 出发执行这个技能能成功的概率(BC/RL 训出来的,见过真实环境)。
每一步贪心地选:
选出一个技能就执行,执行完状态变了,价值函数的打分也随之变化,再选下一个。LLM 负责"语义上对不对",价值函数负责"物理上行不行",两个分数都高才被选中——这就是对"语言概率 × 可执行概率"的乘法 grounding。
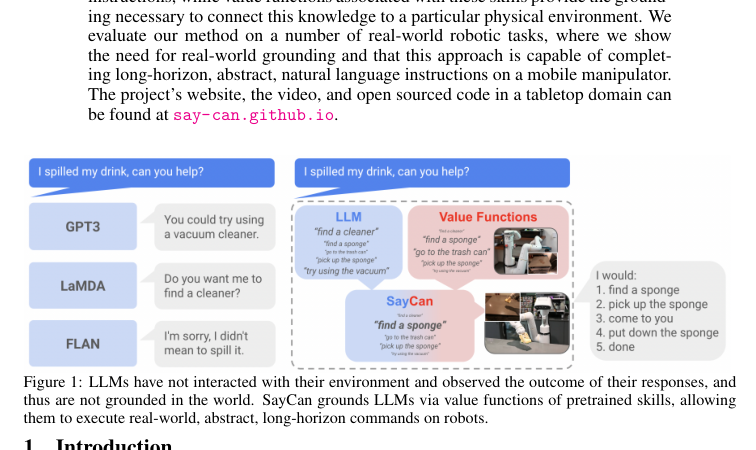
论文里有个很直观的例子(Figure 2):机器人问"怎么把桌面上的垃圾扔掉",桌上有个苹果和一罐可乐。当机器人正对着桌面时,"拿起苹果"和"拿起可乐"的价值函数打分都很高;但机器人走到空旷过道时,所有"拿起 X"的价值函数打分全线归零——此时即使 LLM 语义上还想让它拿东西,乘法也会把这类动作压下去,规划自然切换到"导航去找垃圾"。
#2.3 系统与结果
- 机器人:Everyday Robots 的轮式移动操作机器人(7 自由度臂 + 二指夹爪),真·厨房场景;
- LLM:540B 的 PaLM;
- 技能库:551 个技能(语言条件 BC/RL 策略);
- 评测:101 条真实厨房指令、7 个指令族,全零样本。规划成功率 84%,执行成功率 74%;换到训练分布外的整个厨房环境,规划只掉 3%、执行掉 14%,说明泛化相当好。
#2.4 它留下的问题
- 价值函数本身就是个要逐技能训练的大工程(551 个技能意味着 551 套策略 + 价值函数),扩展技能库的成本极高;
- 整个规划是"逐步贪心选技能",LLM 不生成代码也不做显式推理,表达力有限;
- 一次规划一条链,执行中出错怎么办?——这就引出了 Inner Monologue 的闭环反馈。
#3. ProgPrompt(2022):让计划天生"可执行"
论文:ProgPrompt: Generating Situated Robot Task Plans using Large Language Models,NVIDIA + UW,arXiv:2209.11302,ICRA 2023。
#3.1 它想解决什么
在 ProgPrompt 之前,让 LLM 做规划的主流玩法有两类:一类是 SayCan 式的"枚举所有候选动作打分",动作空间一组合爆炸就完蛋;另一类是直接让 LLM 吐自由文本计划,问题是吐出来的计划里经常混着"伸手拿泡菜罐"这种环境中根本没有的动作或物体。
ProgPrompt 的洞察:既然 LLM 最擅长的语言形式是代码,那就把 prompt 和输出都做成程序。
#3.2 方法:程序化的 prompt
ProgPrompt 的 prompt 结构长得像一段 Python 头文件:
# 环境(situated)信息
import actions from robot
objects = [salmon, microwave, garbagecan, ...]

def make_dinner():
    # 0: find salmon
    find('salmon')
    # 1: cook salmon
    assert('salmon' is 'close')
    open('microwave')
    put('salmon', 'microwave')
    ...
    # 5: close garbagecan
    assert('close' to 'garbagecan') else find('garbagecan')
    assert('garbagecan' is 'opened') else open('garbage')
三个关键设计:
- import 动作、objects 列表:把"这个环境里有哪些物体、机器人有哪些动作"直接写进程序头。LLM 生成的计划只能调用 import 进来的函数、引用声明过的对象,从结构上杜绝了"幻觉出不存在的东西";
- 注释即子目标:
# 1: cook salmon这种自然语言注释既是 few-shot 示例,也是人能读懂的子目标说明; - assert + 恢复分支:
assert('salmon' is 'close') else find('salmon')——执行前检查前置条件,失败了走恢复动作。这是把"环境反馈"塞进程序结构里,已经是闭环重规划的雏形。
#3.3 结果与局限
在 VirtualHome 仿真家务任务上对比自由文本基线:ProgPrompt 在 watch tv、turn off light 等 12 个测试任务上大幅提升(例如 watch tv 任务 SR 0.20 vs 文本基线的 0.00,turn off light 0.40 vs 0.00,详见论文 Table II 的 SR/Exec/GCR 三列),并部署到了真实桌面机械臂上。
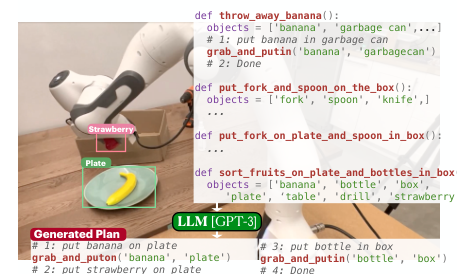
局限也很清楚:动作本体还是一维平铺的动作序列,机器人 API 只有"动词+宾语"这种结构,没有参数化的几何量、没有反馈循环、没有感知调用。"程序"只是个约束格式,还没成为真正的控制程序。
#4. Inner Monologue(2022):给开环规划器接上闭环
论文:Inner Monologue: Embodied Reasoning through Planning with Language Models,Google Robotics,arXiv:2207.05608,CoRL 2022。
#4.1 它想解决什么
SayCan 式规划本质是开环的:计划生成时对环境的认知是初始一次性的,执行中一旦有技能失败(杯子倒了、抓空了),整条链就废了。Inner Monologue 的命题:让 LLM 规划器在执行过程中持续"感知"环境变化,并据反馈重新规划。
关键设计选择:反馈的载体仍然是文本。机器人不新增任何感知模态,而是把感知结果翻译成文字,追加进 LLM 的对话上下文——像人做任务时脑子里持续的"自言自语",故名 Inner Monologue(内心独白)。
#4.2 三种文本反馈通道
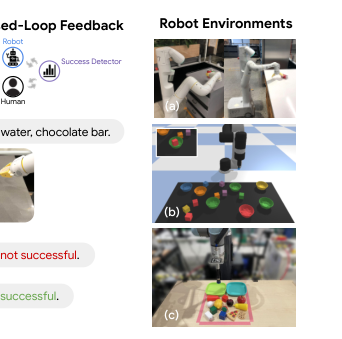
论文考察了三个域(仿真桌面重排、真实桌面重排、真实厨房移动操作)上的多种反馈来源:
- Success Detection(成功检测):每步技能执行完,检测器告诉你"抓取成功/失败",失败文字反馈进上下文,LLM 重规划;
- Passive Scene Description(被动场景描述):每个规划步自动跑物体识别,生成结构化场景文字;
- Active Scene Description(主动场景查询):LLM 可以主动提问"橙色碗里有什么?",把回答作为反馈——这已经隐约是后来的"工具调用/Agent 向环境提问"模式;
- Human Feedback(人类反馈):人直接打字说"不对,往左一点",甚至回答机器人主动提出的问题(如询问用户偏好)。
#4.3 结果
在 120 次评测(三个任务族)中,闭环文本反馈显著提升长程任务完成率,环境反馈与人类反馈互补;论文还展示了一批"涌现"能力——都没专门训练或示例过:机器人能中途接受人类的新指令、原计划不可行时主动提出新目标、用不同自然语言与人交互、回答关于场景的问题。这些能力全部来自"把文本反馈接进 LLM 上下文"这一个改动,可见闭环反馈是这条路线的巨大杠杆。
#4.4 留下的问题
反馈质量完全依赖上游感知模型的可靠性(成功检测器说错了,LLM 就被带偏);所有反馈压成文本,不可避免有信息瓶颈。这个"文本化反馈"的设计到今天仍在 VLA 系统里被反复重新发明。
#5. Code as Policies(2022):从"选技能"到"写控制逻辑"
论文:Code as Policies: Language Model Programs for Embodied Control,Google Robotics,arXiv:2209.07753,ICRA 2023。
#5.1 它想解决什么
SayCan/ProgPrompt 的 LLM 只做"动词级"的技能选择。但很多任务需要逻辑与几何:"把积木推成一行"、"在红色的两个物体之间画圈"、"每次拿起东西前先检查桌面是否干净"——这些不是从技能库里选一条能表达的,需要循环、条件、坐标计算。
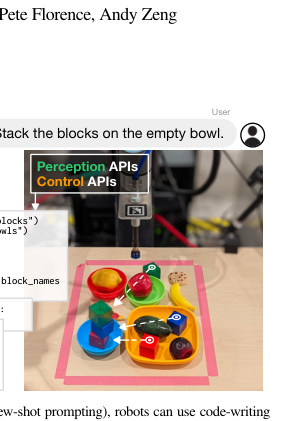
CaP 的主张:直接让 code-trained LLM(Codex 这类)生成可执行的 Python 控制代码。Codex 本来就是"注释→代码"训练出来的,把"自然语言指令"当注释喂进去,输出的就是调用机器人 API 的策略代码:
# 把杯子拿到水槽
move_to(get_obj_pos("cup"))
close_gripper()
move_to(get_obj_pos("sink"))
open_gripper()
#5.2 关键机制
- 感知 API 也是一等公民:代码里可以直接调
get_obj_pos("cup")(物体检测器)、get_surf_normal(...)等感知函数,甚至用 NumPy 做向量运算、用 Shapely 做几何推理。代码在执行时才调感知,所以位置是实时的,不是规划时刻的静态快照; - 层级式代码生成(hierarchical code-gen):LLM 写代码时可以调用一个还没定义的函数(如
stack_blocks_in_row(...)),然后递归地让 LLM 自己补全这个函数的定义。这个技巧显著提升了代码复杂度上限,还顺手把 Codex 在 HumanEval 上的成绩推到 39.8%(当时 SOTA); - few-shot 泛化:给几个"指令注释 + 策略代码"的示例,新指令来了 LLM 自动重组 API 调用生成新代码,不需要重训。
#5.3 结果与局限
在多个真机平台(UR5e 桌面、Everyday Robots 厨房移动操作)上演示了画形状、长程排列等任务;在 CLIPort 式 benchmark 上,CaP 在"未见过的动作语义组合"任务族上把此前为 0 的成功率拉到 73-97%(例如 UA/SI Long-Horizon 任务 CLIPort 36.8%、NL Planner 88%、CaP 97.6%;UA/UI Spatial-Geometric CLIPort 0.0%、CaP 73.3%),组合泛化能力是最大卖点。
局限:系统能力被感知 API 的天花板锁死——get_obj_pos 检测不到的物体,代码写得再漂亮也没用;低层控制原语仍然预定义(move_to/gripper),LLM 无法表达精细力控或连续轨迹。
#6. Instruct2Act(2023):把感知端也变成"API 化的基础模型"
论文:Instruct2Act: Mapping Multi-modality Instructions to Robotic Actions with Large Language Model,上海 AI Lab(OpenGVLab)+ SJTU + PKU + CUHK,arXiv:2305.11176,ICCV 2023。
#6.1 它想解决什么
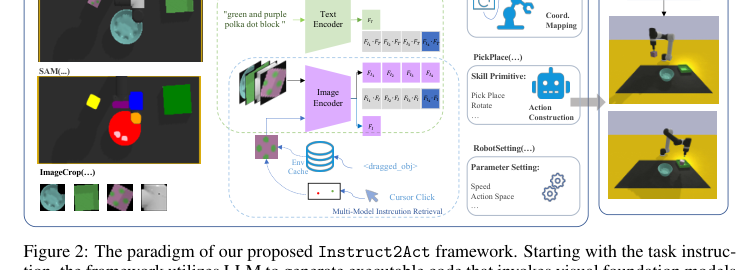
CaP 暴露的感知瓶颈,Instruct2Act 给出了系统化的解法:感知不要自己训专用模型,直接把 2023 年爆发的视觉基础模型当"工具"调。多模态指令(文字+图像)进来,LLM 生成 Python 代码,代码里通过预定义 API 调用一整套视觉基础模型。
#6.2 方法:LLM 编排三个模块
Instruct2Act 把系统拆成 perception / planning / action 三个模块,由 LLM 生成的代码统一编排:
- Perception:代码调 API 触发 SAM(Segment Anything)做开放词汇分割定位候选物体,CLIP 做属性分类,配合 Grounding-DINO、GraspNet 等——感知结果作为变量写回代码;
- Planning:LLM 根据指令生成调用上述感知 API 的 Python 程序,处理"哪个物体、哪个属性、先后顺序";
- Action:感知出的位置、姿态交给低层控制器(抓取用 GraspNet 等)执行。
#6.3 结果与意义
在 VIMA Bench 六个代表性 meta-task 上,这个零训练、零样本的模块化框架就能打平或超过许多专门训练的端到端策略;代码开源(OpenGVLab/Instruct2Act)并作为 benchmark baseline。它的意义在于示范了一种架构判断:当感知基础模型足够强时,"LLM 写胶水代码编排视觉基础模型"是一个不用收集机器人数据就能搭起来的强 baseline——这恰好是 2023-2024 年大量工作(包括 HuggingGPT、各种 tool-use agent)在语言域的同款逻辑,Instruct2Act 是这个逻辑在机器人域的早期代表。
#7. VoxPoser(2023):当技能库表达不了任务,就合成"价值场"替代它
论文:VoxPoser: Composable 3D Value Maps for Robotic Manipulation with Language Models,Stanford,arXiv:2307.05973,CoRL 2023 最佳论文。
#7.1 它想解决什么
前五篇共享一个隐含前提:技能库覆盖了任务所需的动作。但真实指令五花八门——"打开最上面的抽屉,别碰那个花瓶"。技能库里很可能没有"绕开花瓶开抽屉"这个技能,而它对轨迹形状的约束(affordance + constraint)也无法用离散技能选择表达。
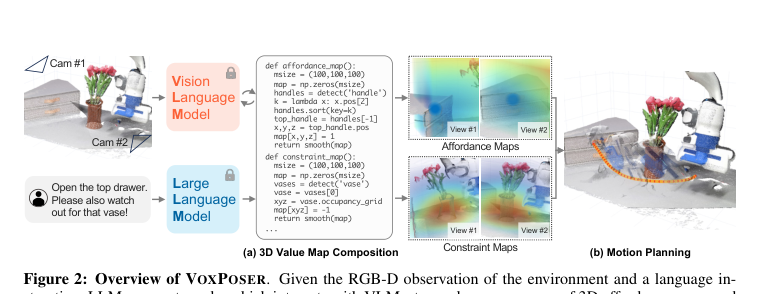
VoxPoser 的洞察:LLM 真正擅长的是推理"指令里隐含的 affordance(该碰哪里)和 constraint(别碰哪里)",那就让它把这些空间知识直接写成代码,合成到 3D 观测空间里。
#7.2 方法:LLM+VLM 合成 3D value map
流程分三步:
- 代码生成:给定 RGB-D 观测和自由形式指令,LLM 生成 Python 代码,代码里调用 VLM(如 CLIP)与开放词汇检测器,对 3D 体素网格做操作——例如"在抽屉把手的体素上写正价值,在花瓶周围写负价值";
- 合成 value map:代码执行的结果是一张与机器人观测空间对齐的 3D value map(affordance 图 + constraint 图的合成)——语言里的空间约束变成了稠密的体素级成本场;
- 轨迹优化 + MPC:用零阶优化(随机采样轨迹、按 value map 打分)合成 6-DoF 末端轨迹,且在 MPC 框架下每步重规划,天然抗干扰(目标动了、抽屉被人拉回去了,都能跟上)。
#7.3 结果与意义
在 13 个日常操作任务上(含未见过任务)零训练完成轨迹合成,平均成功率超过依赖预定义原语的 Code-as-Policies 变体;对比"学习 costmap"的方法(如 U-Net costmap),LLM 显式推理 affordance/constraint 的泛化明显更强;MPC 重规划使其对移动目标、外部干扰鲁棒。
VoxPoser 的地位在于它同时背叛了流派的两个教条:既不让 LLM 选离散技能(它合成连续目标函数),也不依赖预定义运动原语(轨迹由优化器现算)。它证明"LLM 的空间知识可以以 value map 的中间表示接地到感知空间"——这个"中间表示"思想后来在 ReKep(关键点约束)、MPC 式 VLA 后端里反复出现。可以说 VoxPoser 是这条流派从"编排技能"走向"生成目标函数/约束"的转折点。
#8. 横向比较:六个方法到底差在哪
把六篇放一起,能看出三个维度的逐步松动:
| 维度 | SayCan | ProgPrompt | Inner Monologue | Code as Policies | Instruct2Act | VoxPoser |
|---|---|---|---|---|---|---|
| LLM 输出形式 | 逐个给技能打分 | 动作序列代码 | 技能序列 + 文本反馈处理 | 完整 Python 策略代码 | 编排感知+动作的代码 | 生成 value map 的代码 |
| 低层接口 | 551 个语言条件策略 | 动作+宾语 | 同 SayCan 式技能 | 参数化控制原语 | 基础模型 API + 低层控制 | 轨迹优化(无固定技能) |
| 感知来源 | 价值函数隐式感知 | 环境物体列表 | 感知模型→文本反馈 | 感知 API(物体检测) | SAM/CLIP 等基础模型 | VLM + 3D 体素 |
| 闭环方式 | 无(逐步贪心) | assert 恢复 | 文本反馈重规划 | 代码内反馈循环 | 代码内 | MPC 每步重规划 |
| 训练成本 | 551 套策略+价值函数 | 无 | 沿用技能库 | 无(few-shot) | 无(零样本) | 无(零样本) |
演化主线可以总结成三句话:
- 接口的表达力持续升级:打分 → 动作序列 → 代码 → 目标函数。LLM 的输出离"电机"越来越远、离"任务语义"越来越近,而中间层(技能/原语/优化器)承接的复杂度越来越高;
- grounding 的位置持续下移:SayCan 在"技能选择"处 grounding(价值函数打分),VoxPoser 已经 grounding 到体素级空间;
- 闭环越来越实时:从无闭环,到文本级事后重规划,到 MPC 级逐步重规划。
#9. 这个流派的根本局限与它之后的路
这条路线为什么最终没有成为具身智能的终点?四个结构性问题:
- 技能库/原语的天花板就是系统的天花板。 无论如何编排,机器人做不出技能库里没有的"动作模式"。VoxPoser 用轨迹优化绕开了一部分,但力控、柔性操作等仍无解;
- 泛化靠 LLM 的语义组合,物理技能不泛化。 换个机器人本体、换个场景,语言条件策略和价值函数要重训(SayCan 的 551 套技能就是这个成本);
- 延迟与误差在长链条上累积。 LLM 打分/生成代码 → 感知 API → 低层执行,每一层都慢(LLM 推理秒级)且有误差,高频反应式行为根本走不了这条通路;
- 模块间的信息瓶颈全是人工设计的。 文本反馈(Inner Monologue)、API 返回值(CaP)、value map(VoxPoser)——每个中间表示都是研究者拍脑袋定的,端到端学习理论上可以学到更优的中间表示。
这四个问题恰好是 2023 年之后 RT-2、OpenVLA、π0 这类 VLA 端到端路线的直接卖点:动作直接从头模型输出,不需要技能库,反应频率高,本体换了微调即可。所以 2023-2025 年的主叙事确实是端到端 VLA。
但要注意,这条流派并没有死,而是换了个形态活在今天:
- 分层架构回归:π0、Figure Helix、各类 "System 1/System 2" 设计里,上层慢推理(VLM 规划)+ 下层快控制的双层结构,本质就是"规划器 + 技能库"的 VLA 化版本——只是中间表示从自然语言技能描述换成了学出来的 latent;
- 代码接口成为 Agent 领域标配:CaP/Instruct2Act 式"LLM 写代码编排工具 API"就是今天所有 tool-use agent、MCP 生态的直系祖先;
- value map / 约束中间表示延续:ReKep 等约束式操作、以及 MPC-VLA 混合系统里都有 VoxPoser 的影子。
#10. 对 LLM Agent 研究者的启发(结合 wenjun 的兴趣)
最后从"这条路线对做 LLM Agent / 长轨迹 RL 的人有什么用"的角度提炼几点:
- "规划器 + 技能库"是绕开长轨迹 RL 的经典架构性方案。 它把 horizon 压缩到技能级,让 LLM 只在语义层做决策,恰好躲开了超长轨迹上的 credit assignment 难题。这对"长轨迹直接 RL 是否可持续"这个问题是一个架构层面的旁证:分层/技能抽象本身就是一种 credit assignment 方案;
- Affordance 打分 = 世界模型的不确定性接口。 SayCan 的价值函数本质上是"当前状态-动作的可执行性模型",可以看作一个退化版 model-based 组件。如果把它替换成学到的 world model 的 rollout 评估,就非常接近 model-based RL 的轨迹评估逻辑——这正好落在文俊关注的 LLM model-based RL 方向上;
- 中间表示的选择决定了系统的泛化上限。 文本(Inner Monologue)→ 代码(CaP)→ value map(VoxPoser),中间表示越贴近任务结构、越能被优化器消费,系统表达力越强。这对 latent-space reasoning 的启示是:latent 不是越"隐"越好,关键是它要能作为下游规划/优化的目标函数或约束被消费;
- 闭环反馈的形态决定纠错能力。 Inner Monologue 用文本、VoxPoser 用 MPC,纠错粒度差了两个数量级。做 agent 系统时,"反馈以什么粒度、什么频率回到决策层"是比"反馈内容"更重要的设计决策。
#参考文献
- SayCan: Ahn et al., Do As I Can, Not As I Say: Grounding Language in Robotic Affordances, CoRL 2022. arXiv:2204.01691
- ProgPrompt: Singh et al., ProgPrompt: Generating Situated Robot Task Plans using Large Language Models, ICRA 2023. arXiv:2209.11302
- Inner Monologue: Huang et al., Inner Monologue: Embodied Reasoning through Planning with Language Models, CoRL 2022. arXiv:2207.05608
- Code as Policies: Liang et al., Code as Policies: Language Model Programs for Embodied Control, ICRA 2023. arXiv:2209.07753
- Instruct2Act: Huang et al., Instruct2Act: Mapping Multi-modality Instructions to Robotic Actions with Large Language Model, ICCV 2023. arXiv:2305.11176
- VoxPoser: Huang et al., VoxPoser: Composable 3D Value Maps for Robotic Manipulation with Language Models, CoRL 2023. arXiv:2307.05973