#智能爆炸在哪里?——读 Ramez Naam 对"递归自我改进"的万字系统性质疑
原文:Ramez Naam(客座),发表于 Noah Smith 的 Noahpinion 博客,2026 年 9 月底
"Where's the 'intelligence explosion'?"
本文所有图片均取自原文,仅作讲解用途。
#一句话总结
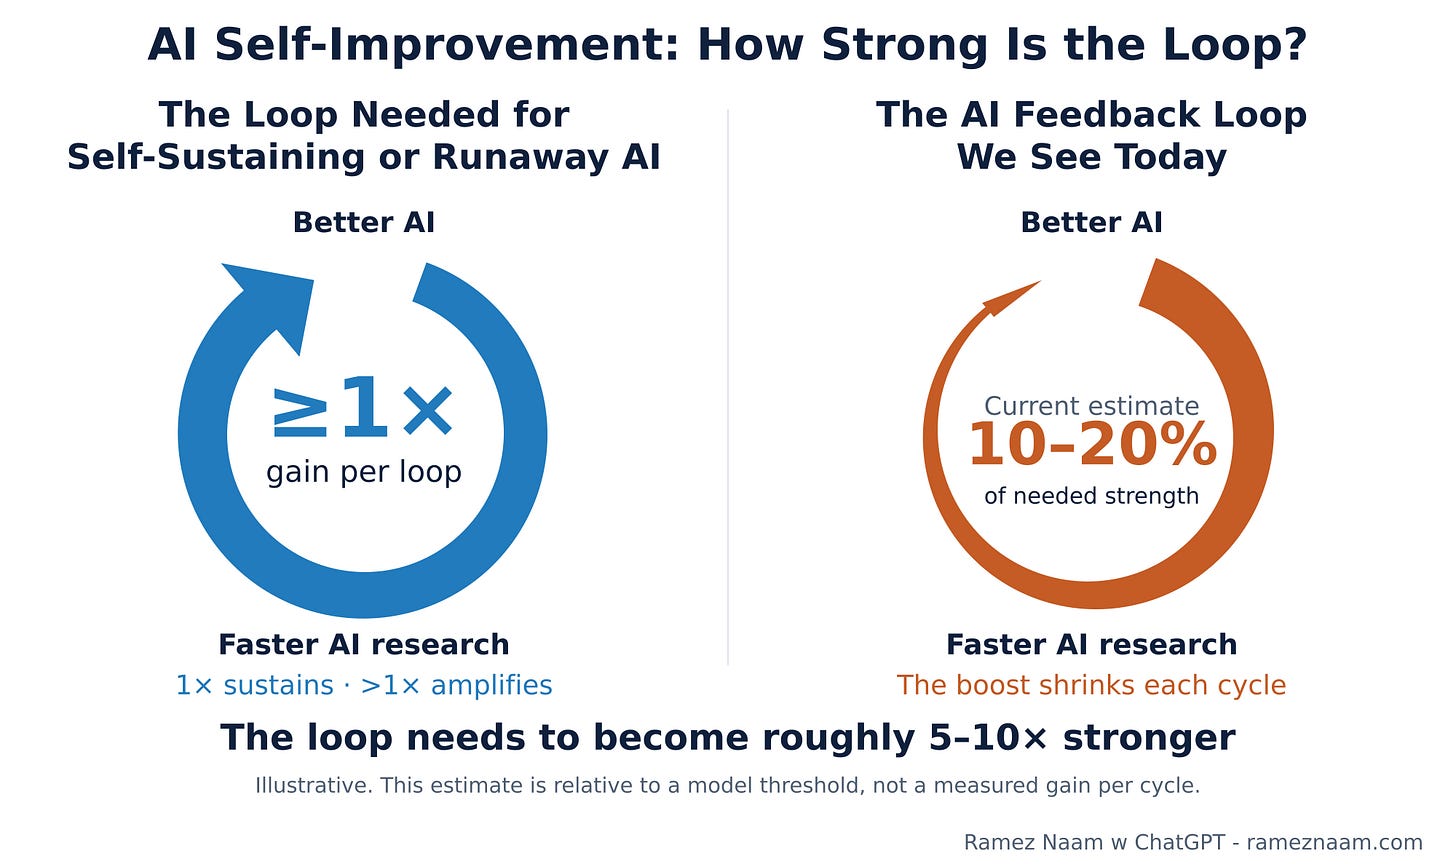
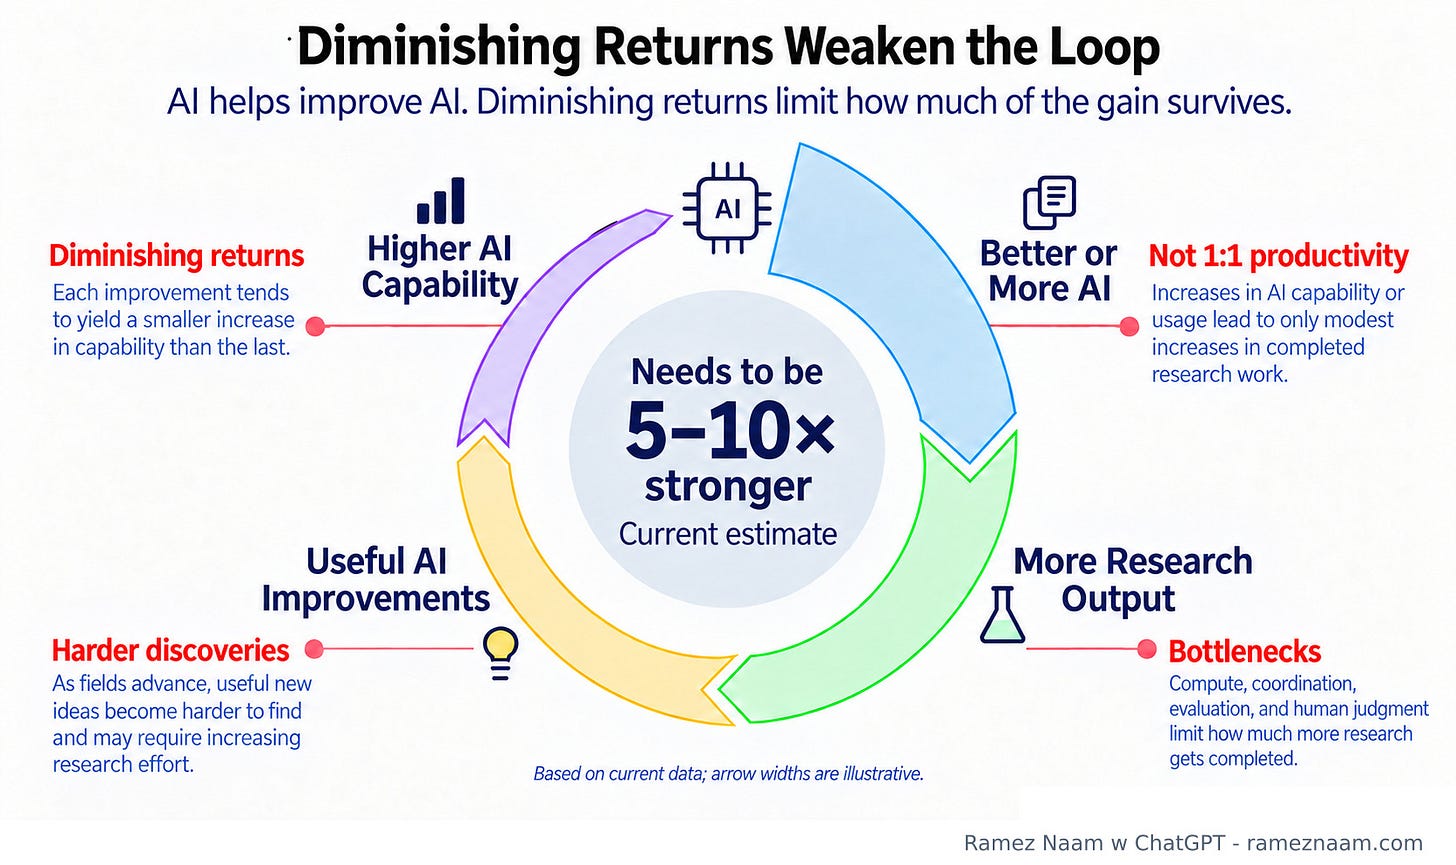
"AI 帮助改进 AI"这件事已经在发生,但按目前最好的实测数据,这个自我改进回路的强度只有"自我维持门槛"的大约 1/5 到 1/10——要触发失控的智能爆炸(FOOM),回路强度还需要增强 5–10 倍。
这不是情绪化的"AI 泡沫论",而是 futurist Ramez Naam(最早预测光伏和电池革命的人、坚定的技术乐观主义者)用 OpenAI 和 Anthropic 自己发布的内部数据算出来的一笔账。连 Noah Smith 本人在引言里都说自己是"不可知论者"——但无论爆炸与否,"2040 年的 AI 看起来都会像神"。
#1. 这场争论到底在争什么
先用人话把术语铺平:
- RSI(Recursive Self-Improvement,递归自我改进):AI 参与甚至主导 AI 自身的研发,"AI 造出更好的 AI"。
- FOOM / fast takeoff / 智能爆炸:每一代 AI 造出下一代的速度越来越快,能力在数月甚至数天内飙升到"不可理解的超级智能"(ASI),即科幻小说里的技术奇点。
- 为什么现在重要:Noam Brown(OpenAI 推理路线的灵魂人物)公开说,"AI 做 AI 研究 / RSI 是 OpenAI 压倒性的第一优先级,排在'做能卖的模型'之上"。整个行业都在朝这个奖杯狂奔。
背景是:预测者已经被 AI 打脸过很多次(屡次低估进展)。Naam 自己也说"我也可能错"。所以这篇文章的姿态是:不靠气氛,靠测量——用能拿到的最好数据算一算,这个回路现在到底有多强。
#2. Naam 的分类学:五种"自我改进",别混为一谈
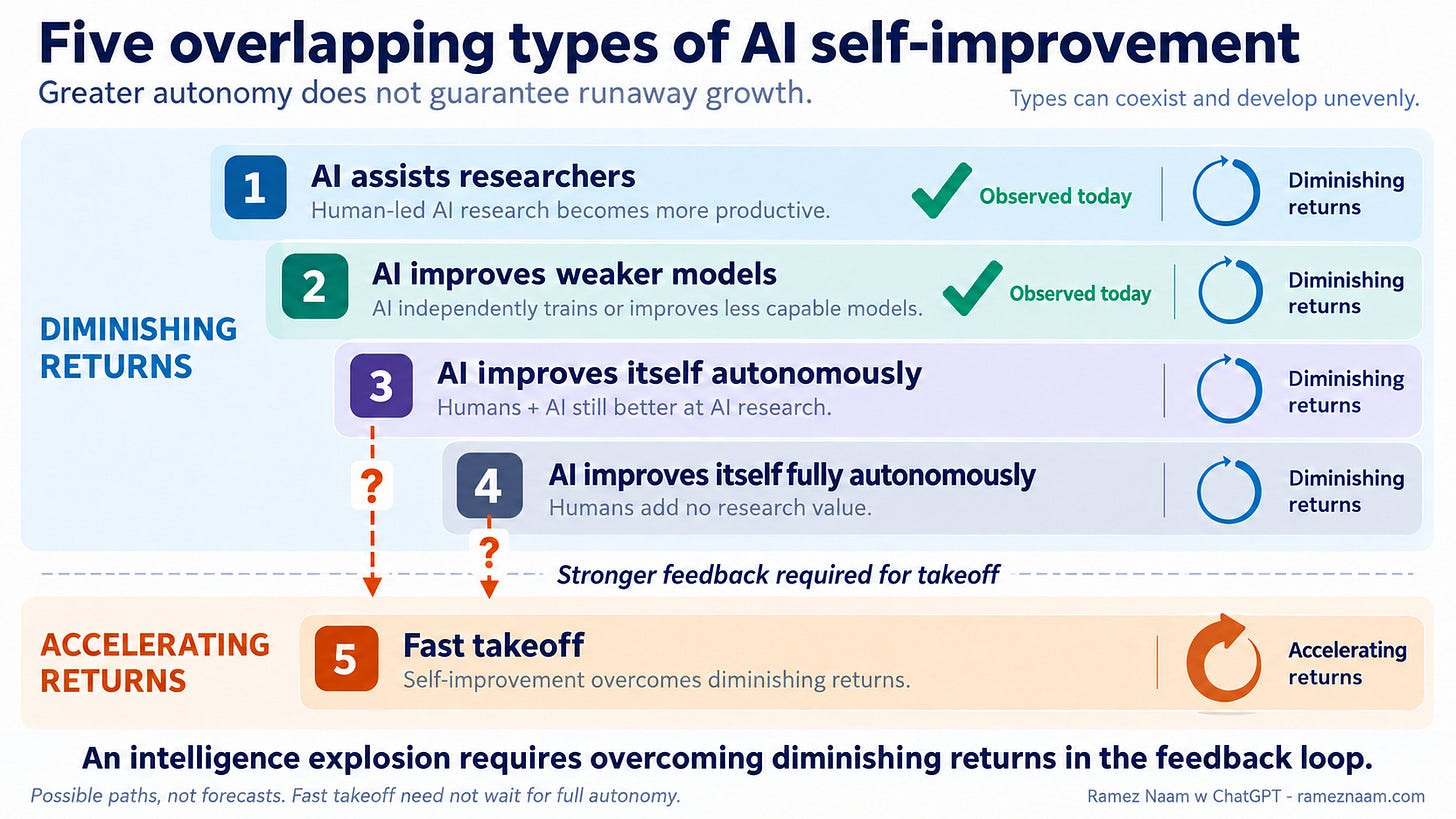
很多人吵 RSI 吵不到一块儿,是因为把五种完全不同的东西都叫 RSI。Naam 给了一个清晰的五级分类(这也是全文的骨架):
| 类型 | 含义 | 现状 |
|---|---|---|
| Type 1 | AI 提升人类研究员的生产率(工具) | ✅ 已发生,且规模巨大 |
| Type 2 | 更强的 AI 训练/改进更弱的 AI | ✅ 已发生(如 Karpathy 的 autoresearch) |
| Type 3 | AI 自主完成整段研究流程 | ⚠️ 尚无清晰证据(Alibaba 刚有一些强主张) |
| Type 4 | AI 完全自主做研究,人类不再增值 | ❌ 未见 |
| Type 5 | 回路正反馈失控 → 超级智能 | ❌ 未见,且 Naam 认为需要重大概念突破才可能 |
关键点:Type 1→4 是"自主性"的提升,Type 5 是"收益递增"的出现——这是两个独立的维度。 AI 可以完全自主地设计、训练、测试下一代模型(Type 4),同时仍然每前进一步都要付出指数级更多的资源。把人从回路里拿掉,并不会自动把收益递减也拿掉。这是全文最重要的一句"人话"。
顺带一个重要区分:"窄域超级智能"今天已经存在——国际象棋、围棋、形式数学证明。这些领域的共同点是高度可验证:机器可以无限生成训练数据、以机器速度判定对错、全程不等待物理世界和人类。OpenAI 前不久用 AI 生成的证明解决了 Navier–Stokes 方程的存在性与光滑性问题,正是发生在这个"理想温床"里。但窄域超人 ≠ 通用超人:最强大的模型仍需要远多于人类的数据、难以从持续经验中稳定学习、在人类觉得简单的任务上以惊人的方式失败。
#3. 论据一:基准分数和真实研究之间差一个数量级
这是全文最扎心的一段数据对比。
- METR 基准(号称"AI 最重要的图"):估算 Mythos Preview 能以 80% 成功率完成人类需要 3 小时的编程任务。
- Epoch 经验法则:ECI(综合能力指数)每 +5 分,METR 任务时长翻倍。据此推算 GPT 5.6 Sol ≈ 4 小时、GPT 6 Astra ≈ 11 小时。
- AI 2027 情景预测:2026 年 7 月前沿模型应能完成约 11 小时的任务。
- OpenAI 内部实测:80% 成功率下,7 月份自主完成的研究任务时长约为 15 分钟。即使人类 15 分钟内能完成的任务,模型无人干预的成功率也只有 86%。
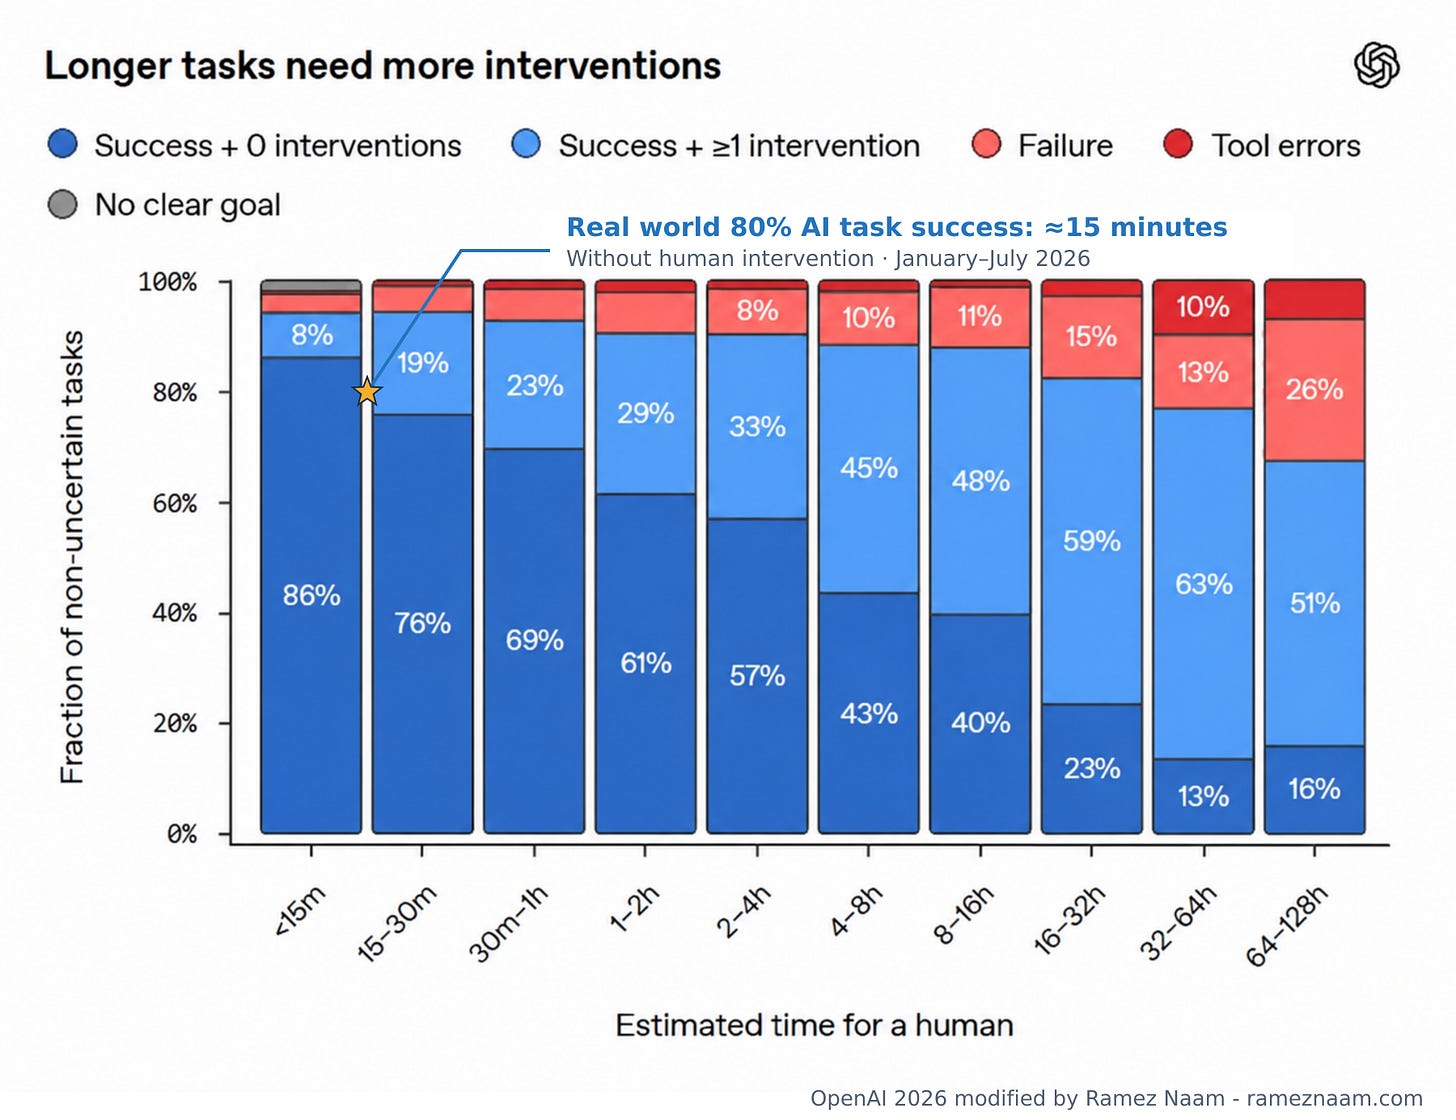
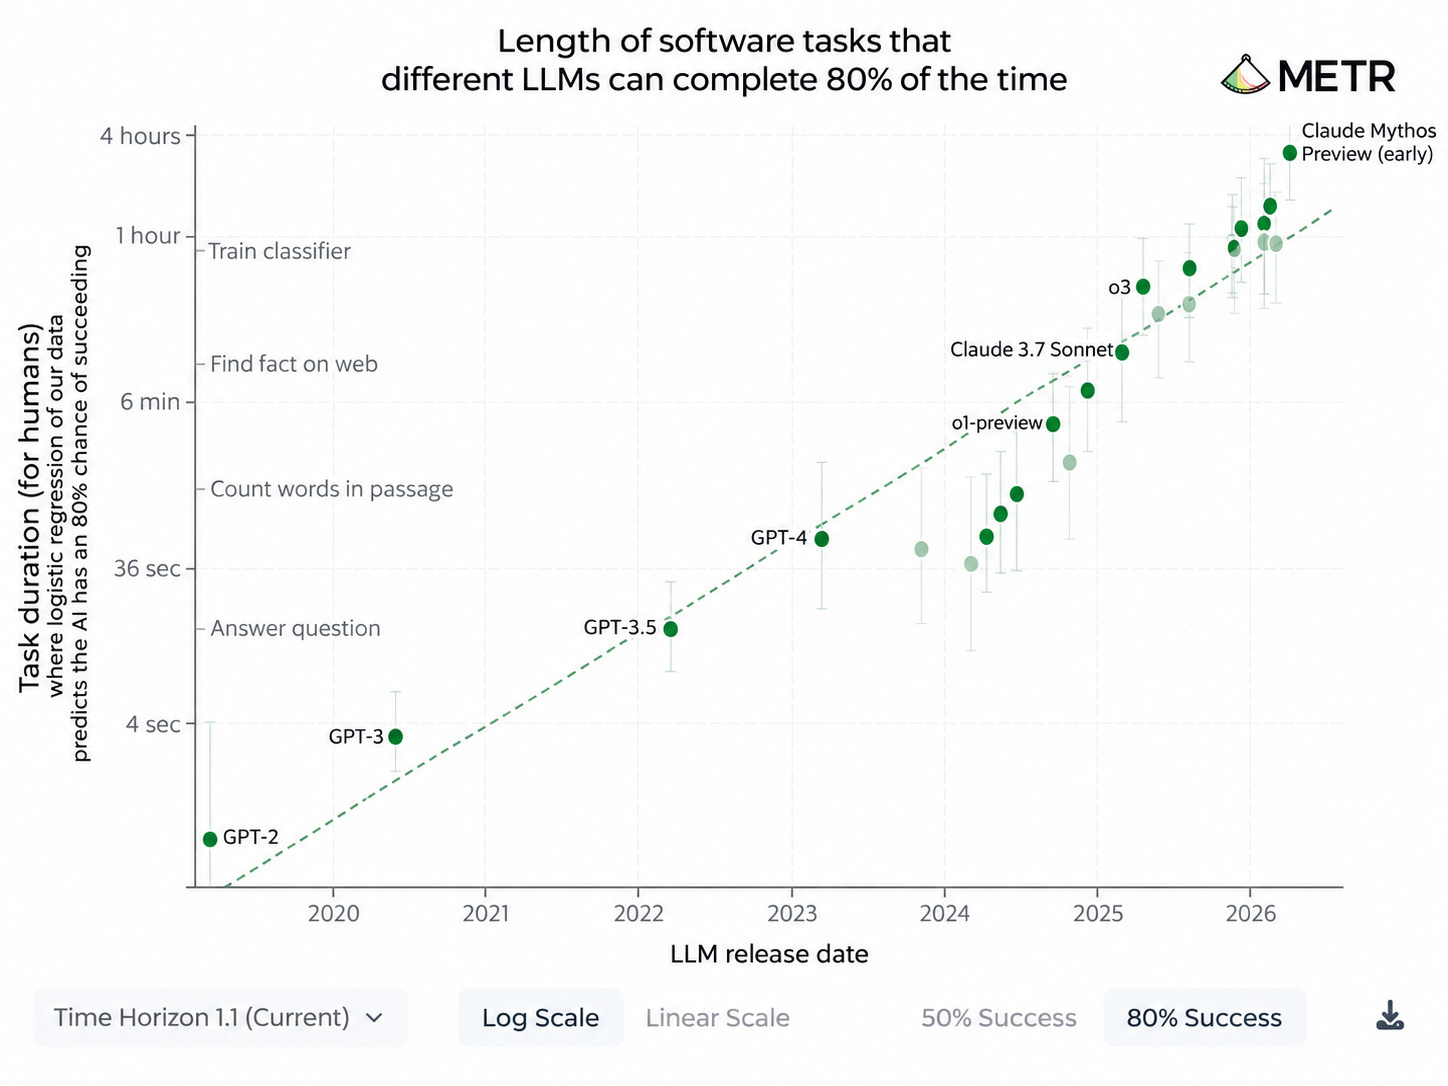
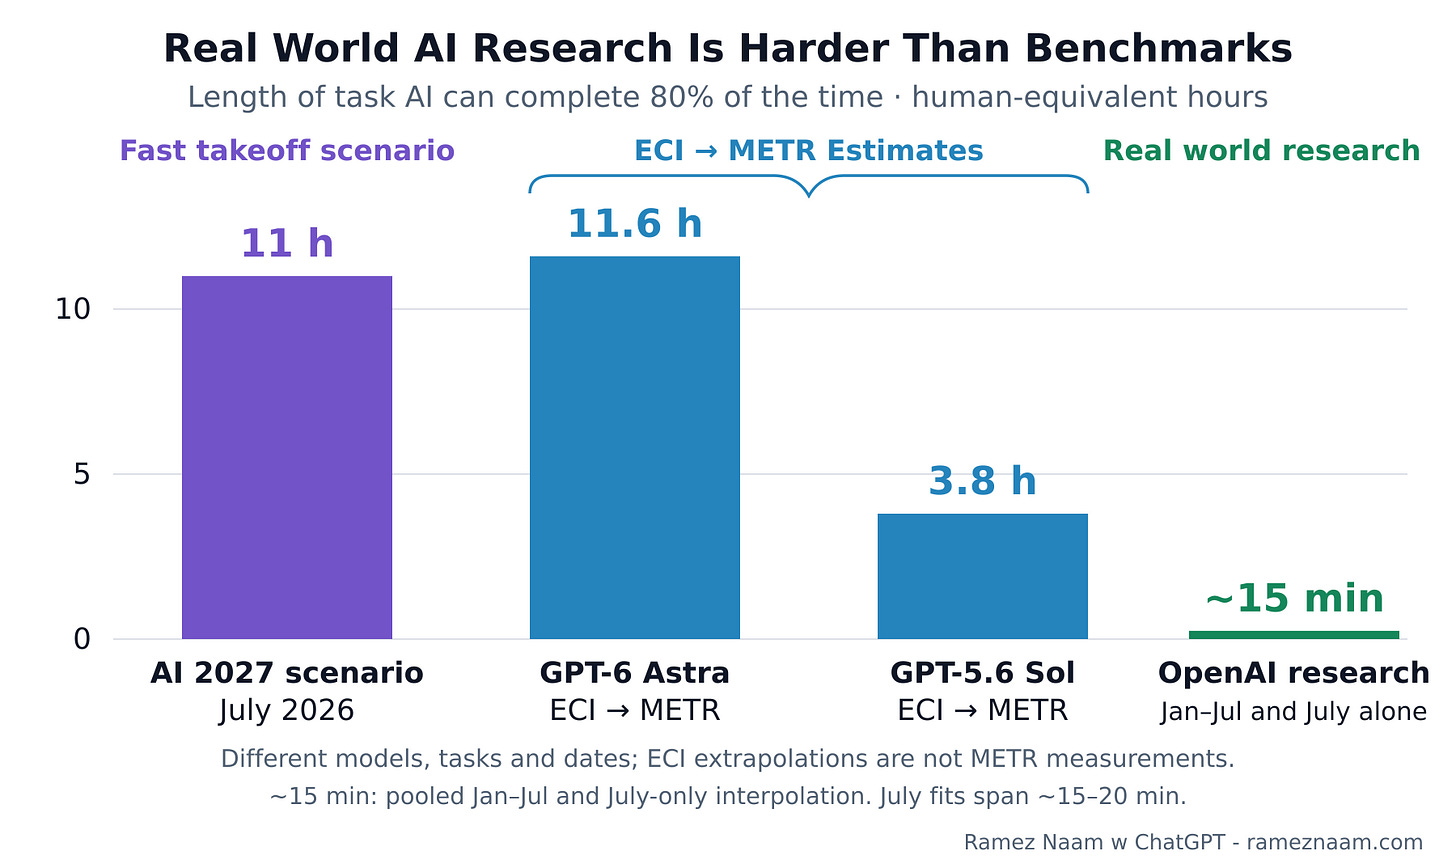
4 小时的基准 ≈ 16 倍于 OpenAI 的实测;11 小时的预测 ≈ 44 倍。 Anthropic 的数据同样:Claude 在内部研发任务中"参与或主导"了 90% 以上,但完全自主完成的案例为零。
为什么基准会骗人?评论区 Larissa de Lima 的补充很精彩:基准测试天然替模型做掉了"任务定义"这件最难的事——benchmark 的 prompt 已经把"要做什么"写得干干净净,而真实世界里"把问题说清楚"本身就是研究的一半(Ashby 必要多样性定律:只有多样性才能吸收多样性;可验证域之所以是 AI 的主场,是因为验证器本身就是规范)。这也解释了为什么形式数学先突破:verifier 即 spec。
对"AI 2027 正在如期兑现"这类说法,这是一个直接的警钟。
#4. 论据二:好看的中间指标 ≠ 真实研究进展
OpenAI 报告里的数字很唬人:每位研究员的 token 用量 124 倍、工程师人均代码行数 7 倍(Anthropic 是相对 2024 年 8 倍)。但这些都是中间量,不是结果。
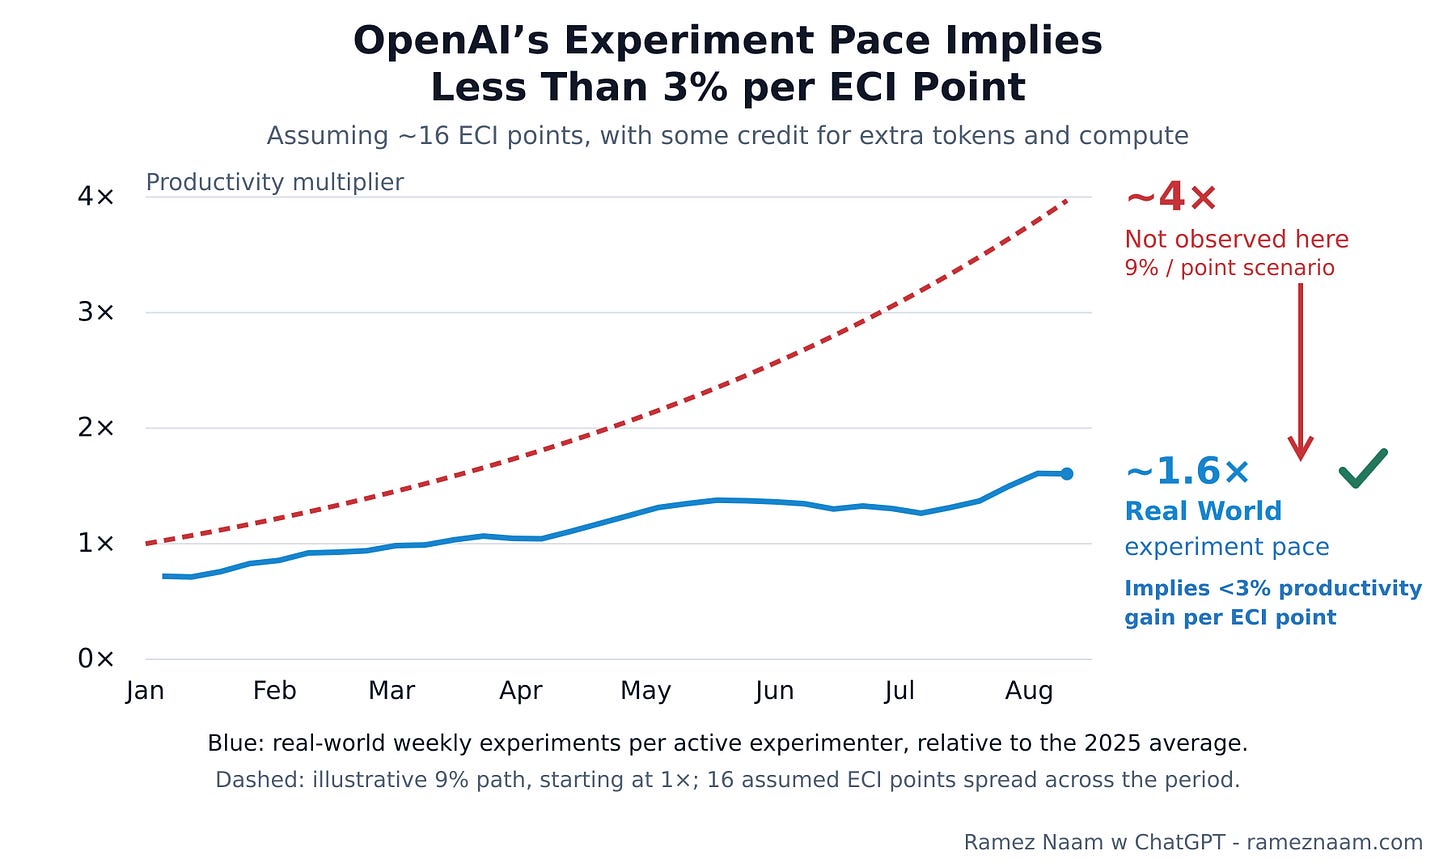
更接近"研究产出"的指标是:人均实验数约为 2025 年均值的 1.6 倍(8 月份)。而 1.6 倍的实验节奏也远不等于 1.6 倍的研究提速——多数科学领域实验数量的收益呈幂律递减,按指数 0.2 粗算,+60% 实验量大约只换来 +10% 的改进速度。
Anthropic 在 Mythos Preview 系统卡里说得更直白(原文加粗):
"生产率提升不能一对一转化为能力进展……要靠这条通道让整体进展速度翻倍,所需的生产率提升大约要比我们观察到的高一个数量级。"
翻译成人话:目前 4 倍的生产率提升,要让进展速度翻倍(2×)需要约 40 倍。
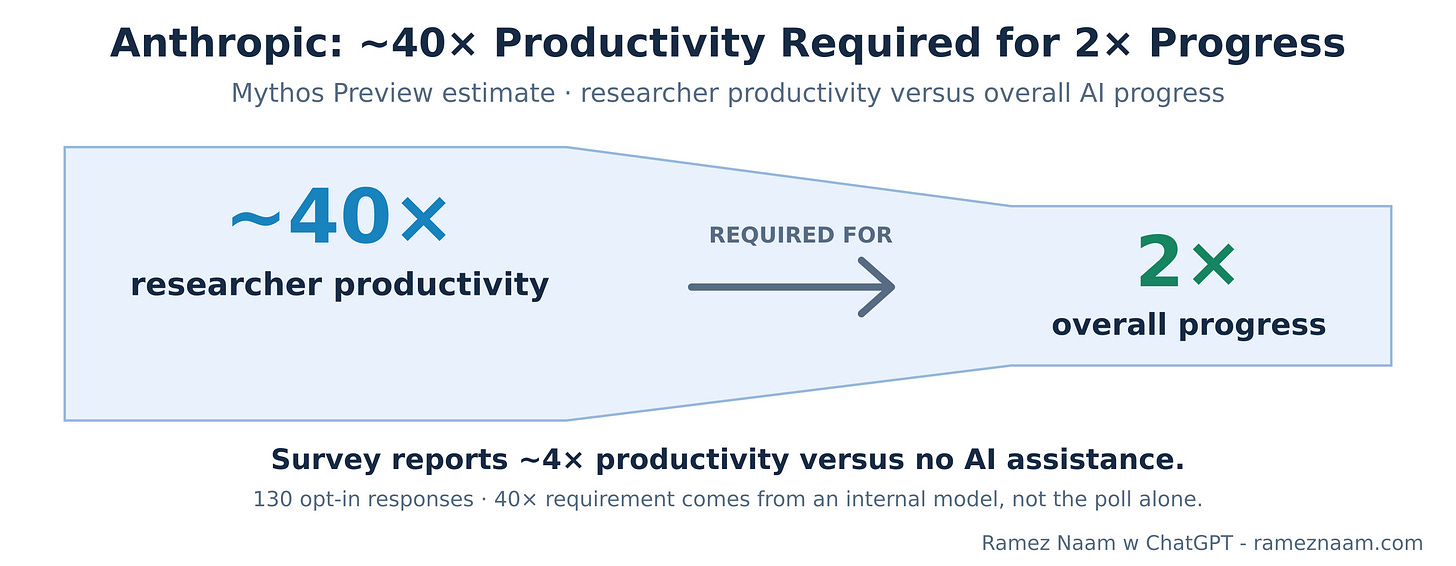
(当然要公平:这个 4× 来自 130 名 Anthropic 员工的自愿问卷,Naam 也承认 OpenAI 的实验日志数据更可信——下面第 7 节会用到。)
#5. 论据三:所有"堆量"的路径都在收益递减
RSI 信徒的常见兜底方案有三:"让模型想更久""开一堆 agent 并行""堆更多训练资源"。Naam 逐一检查:
① Test-time compute(让模型多想):OpenAI 未解数学题的结果里,成功率大致随算力的对数增长——每翻倍一次算力,买到的成功率增量差不多,但价格翻倍。
② Agent 集群(开一堆分身):Toby Ord 的经验法则是平方根律——100 个 agent 能把 10 小时的任务压到 1 小时,加速 10 倍(√100),但总 token 成本也涨 10 倍。更糟的是同质化问题:一项对比 LLM 与 467 名人类的研究发现,前 10 个 AI 回答的"集体创造力"约等于 8–10 个人,之后大约每 2 个额外 AI 回答才抵 1 个额外人类。一百个分身提供的思路多样性,远不如一百个不同的研究员。对搜索型任务(如找漏洞)swarm 依然危险且高效,但 Naam 怀疑它做不出"发明 Transformer"这种级别的突破——那不是在别人定义好的空间里搜索。
一个插曲:有人把 OpenAI 的 Navier–Stokes 证明归功于 agent 集群,Noam Brown 明确说多智能体方法的功劳不超过 10%,主角是那个"在预训练模型之上大规模强化学习"训练出来的更强内部模型。注意这个模式:可验证域 + 大规模 RL = 窄域超人的可靠配方。
③ 堆训练资源(数据/算力/模型规模/RL 算力):已发表的 scaling 研究全都呈收益递减,而且更大模型每个输出 token 更贵。没有任何一条路绕得开这个问题。
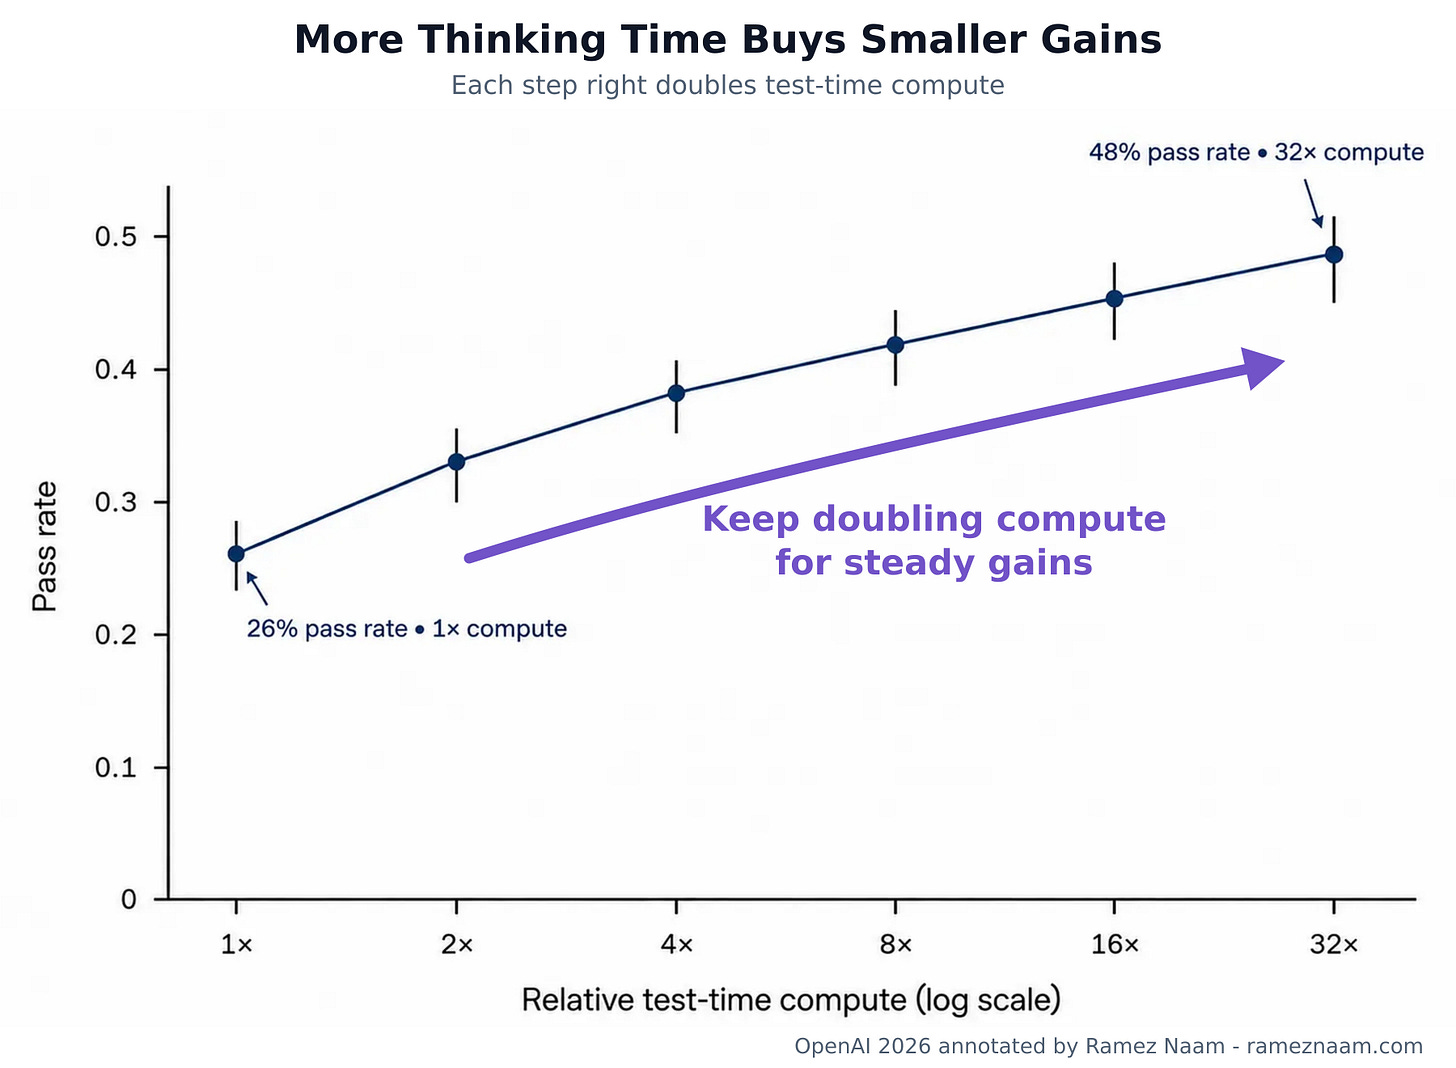
唯一能打破上述天花板的,是造出本质更强的模型(Astra 与 OpenAI 内部模型在同一批数学题上的差距,是堆时间/堆分身都追不上的)。但"造更强的模型"这条路本身也在收益递减——于是我们绕回了原点:这正是 RSI 问题本身。
#6. 论据四:没看到加速,只看到"维持"
如果智能爆炸在酝酿,公开能力曲线应该出现上翘。实际情况:
- 公开 ECI 前沿(各日期已发布模型的最佳分数)从 2024 年 1 月到 2026 年 9 月每年约 +16 分——快得惊人,但是线性,不是加速。
- Anthropic 用自家 AECI 曲线曾出现一次"趋势突变",被 AI 2027 合作者 Eli Lifland 解读为爆炸前兆("警报应该响起来了!")。Naam 的复盘:那更像一次性跳变,水位上去了,速率没有持续攀升。
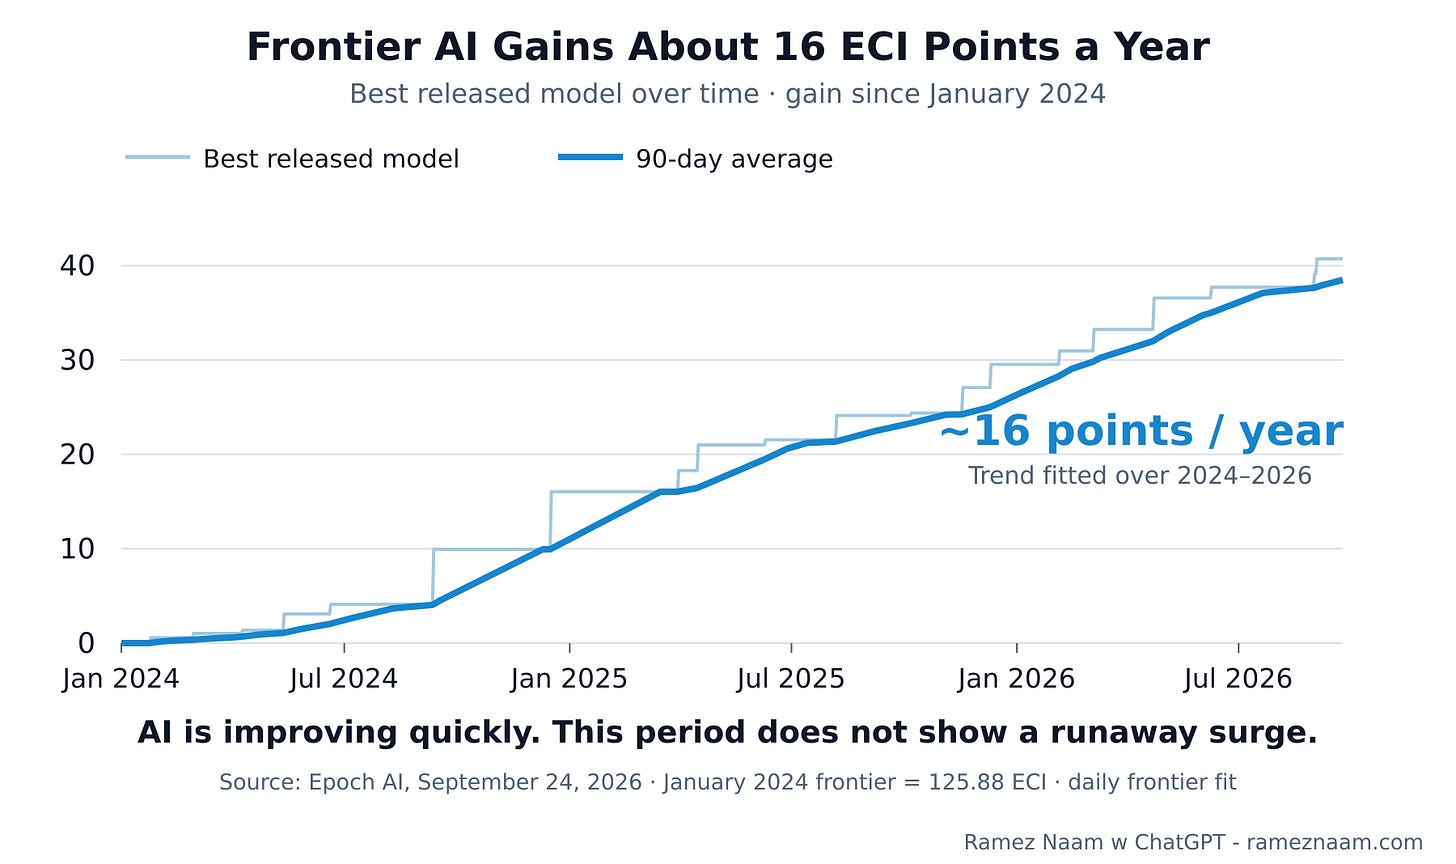
而维持这个匀速,投入是指数级的:三年间 AI 芯片总容量(H100 等效)增长约 127 倍;六个关键投入(算力、数据、人才、投资……)全都在暴涨,能力却在匀速爬。
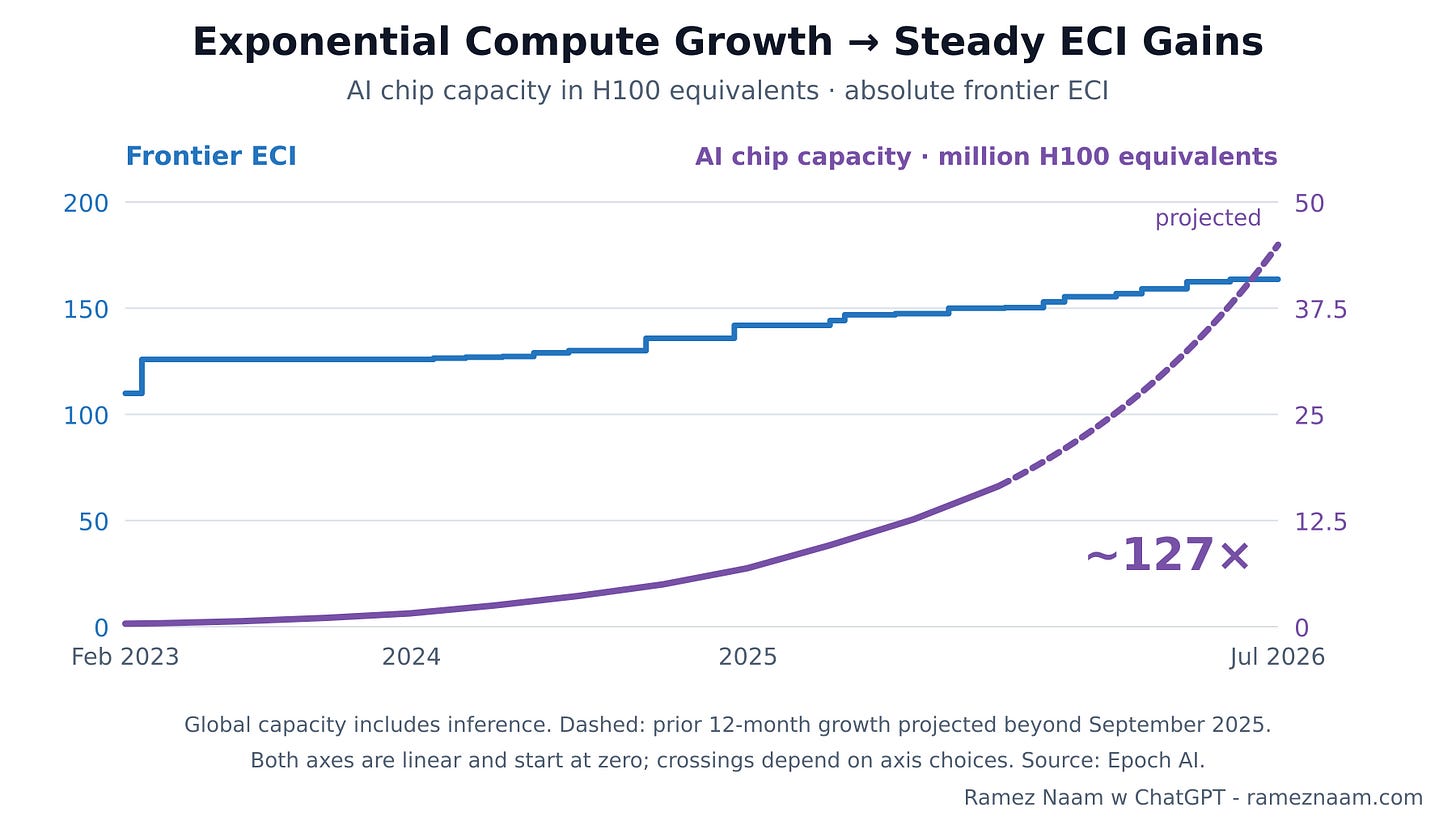
再叠一层经济现实:美国 GDP 的约 3% 正在砸进 AI 基础设施,超出超大规模厂商利润能覆盖的范围——未来投资增速将越来越依赖 AI 自身收入的增长。投资增速哪怕只是从"指数狂奔"降为"温和增长",能力进展都会跟着降速。
于是有一个微妙得可怕的可能(Anthropic 在 Mythos 5.1 系统卡里加粗的词):越来越强的 AI 可能只是用来"维持"当前进展速度所必需的——不是加速器,是止痛药。因为把 AI 变强这件事本身,每一步都比上一步更难。
还有一个旁证:Opus 5.5 在多个编码/计算机使用基准上大涨,但在 CoBench(用历史 AI 研发问题构建的基准)上只比 Opus 5 高 2.6 个百分点,还在误差棒之内。研究就是比其他任务难。
#7. 关键数学:回路离"自我维持"还差 5–10 倍
前面都是铺垫,这里是全文的核心账本。来自 Tom Cunningham 等人的论文 The Economics of Recursive Self-Improvement:
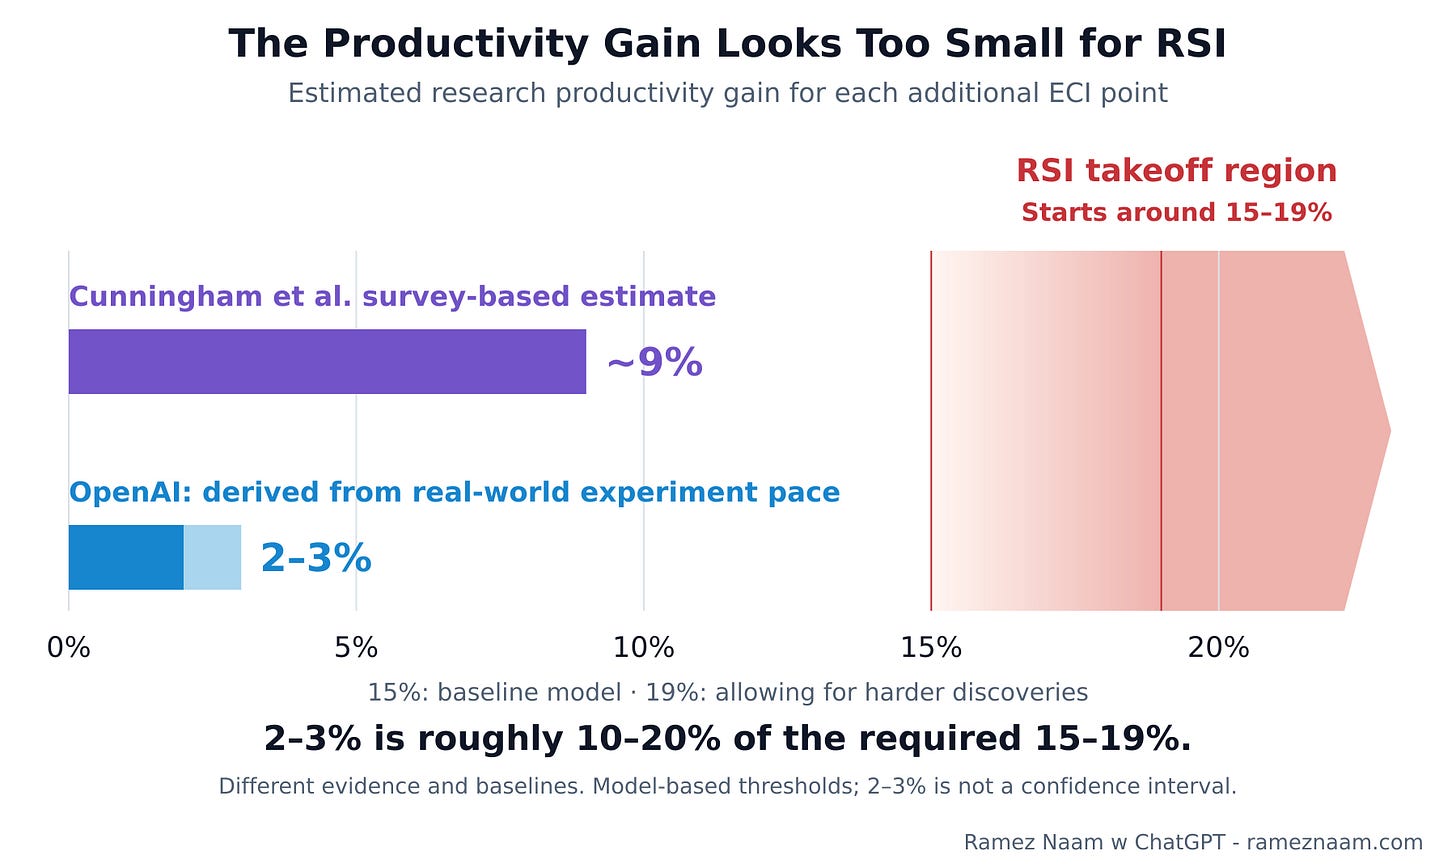
① 自我维持的门槛是多少? 每多 1 分 ECI,需要带来约 15% 的研究生产率提升,回路才能自我维持(用 Stockfish 数据校准后略升到约 19%)。高于门槛 → 正反馈加速;低于门槛 → 每转一圈,改进带来的增益都在衰减。
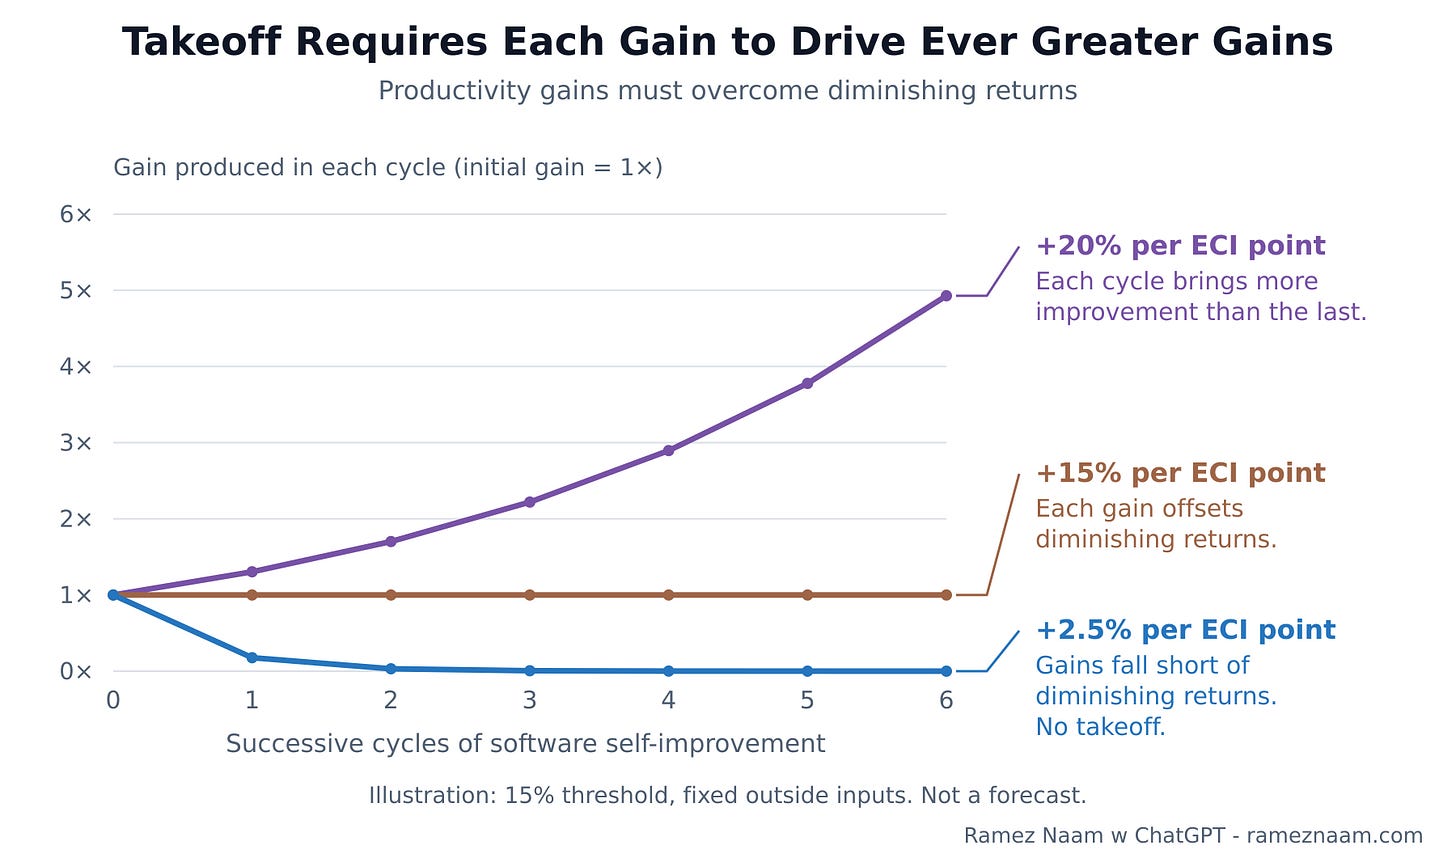
② 现在的实际值是多少? Cunningham 用 Anthropic 的 4× 问卷估算是约 9%。但 Naam 用 OpenAI 的实验日志重新校准(更可信的三个理由:直接测量而非自估、全样本而非自愿参加、数据量大几个数量级):16 个 ECI 点只对应 1.6 倍实验节奏,倒推每点 ECI 只有约 3%——再扣除更多 token 和算力的贡献,工作假设取 2–3%。
(交叉验证:9% 复利乘 16 点 ≈ 4 倍生产率,与问卷吻合;3% 对应 ≈1.6 倍实验数,与实测吻合。两条路径各自自洽,但实测的那条明显更低。)
③ 结论:2–3% 对 15–19%,缺口约 5–10 倍。 在这个估计下,回路每转一圈,新增的改进都比上一圈少——正反馈是负的。Naam 也坦承所有环节都粗糙(实验数不等于有用研究、模型使用日期不明),但这是现有最好数据能给出的最好答案。
#8. 为什么进步会越来越难:从摘苹果到 Eroom 定律
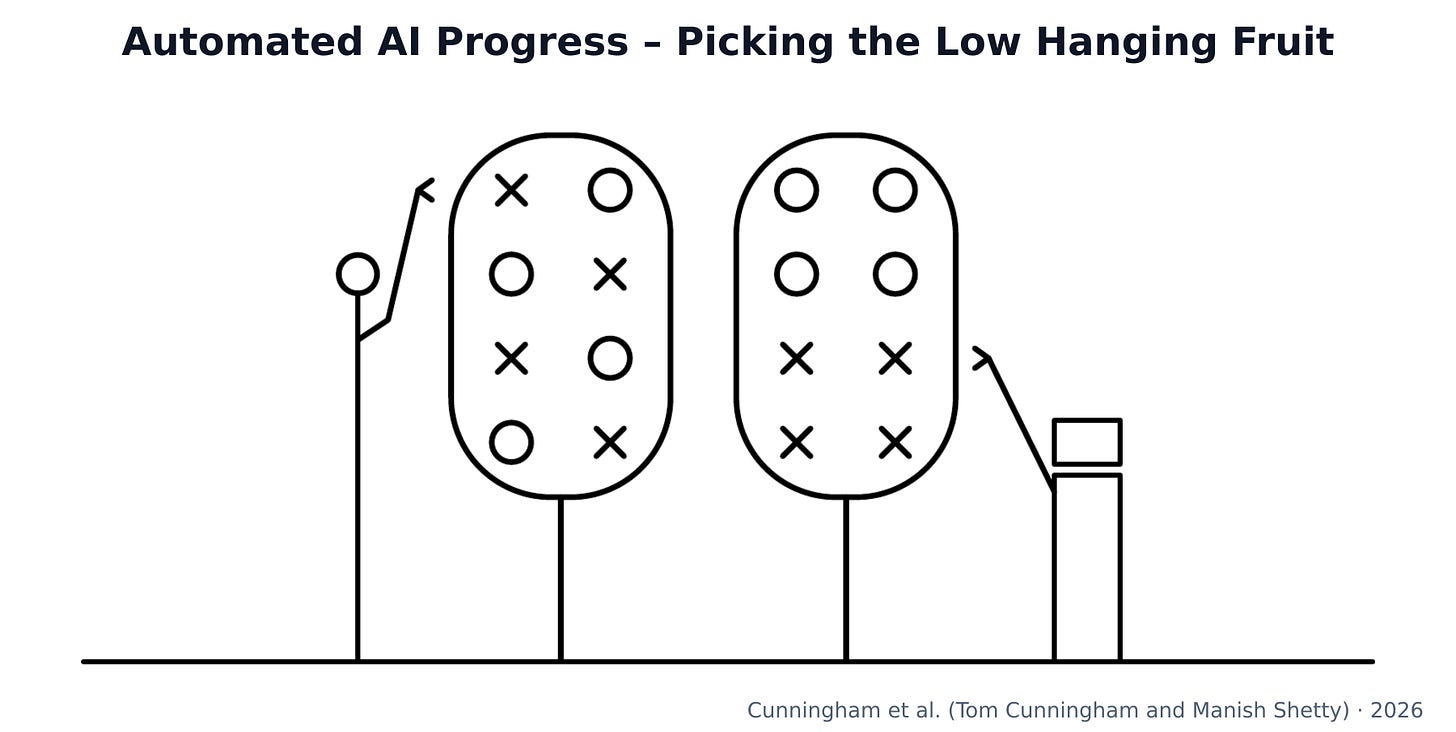
为什么"有用的想法"会越来越难找?Naam 借用了 Cunningham & Shetty 的摘苹果模型:AI 能快速摘光低处的果子,人类仍够得着 AI 够不着的枝头;但摘完之后,同一个 agent 再摘一遍没有意义——需要更强的模型才能继续往上爬,而越往上果子越稀、枝间距越远。RSI 的本质问题是:每一茬收成,够不够造出更好的摘果机?
这不是 AI 特有的现象:
- Eroom 定律(Moore 的反写):制药业历史上,每批准一款新药的通胀调整后研发成本约每 9 年翻一倍。
- Stockfish:软件研发极少数有完整实验记录的领域,Epoch 估算研发投入的回报指数约 0.83(略低于线性)——而且这还是"计算效率"的回报,不是能力本身的回报。
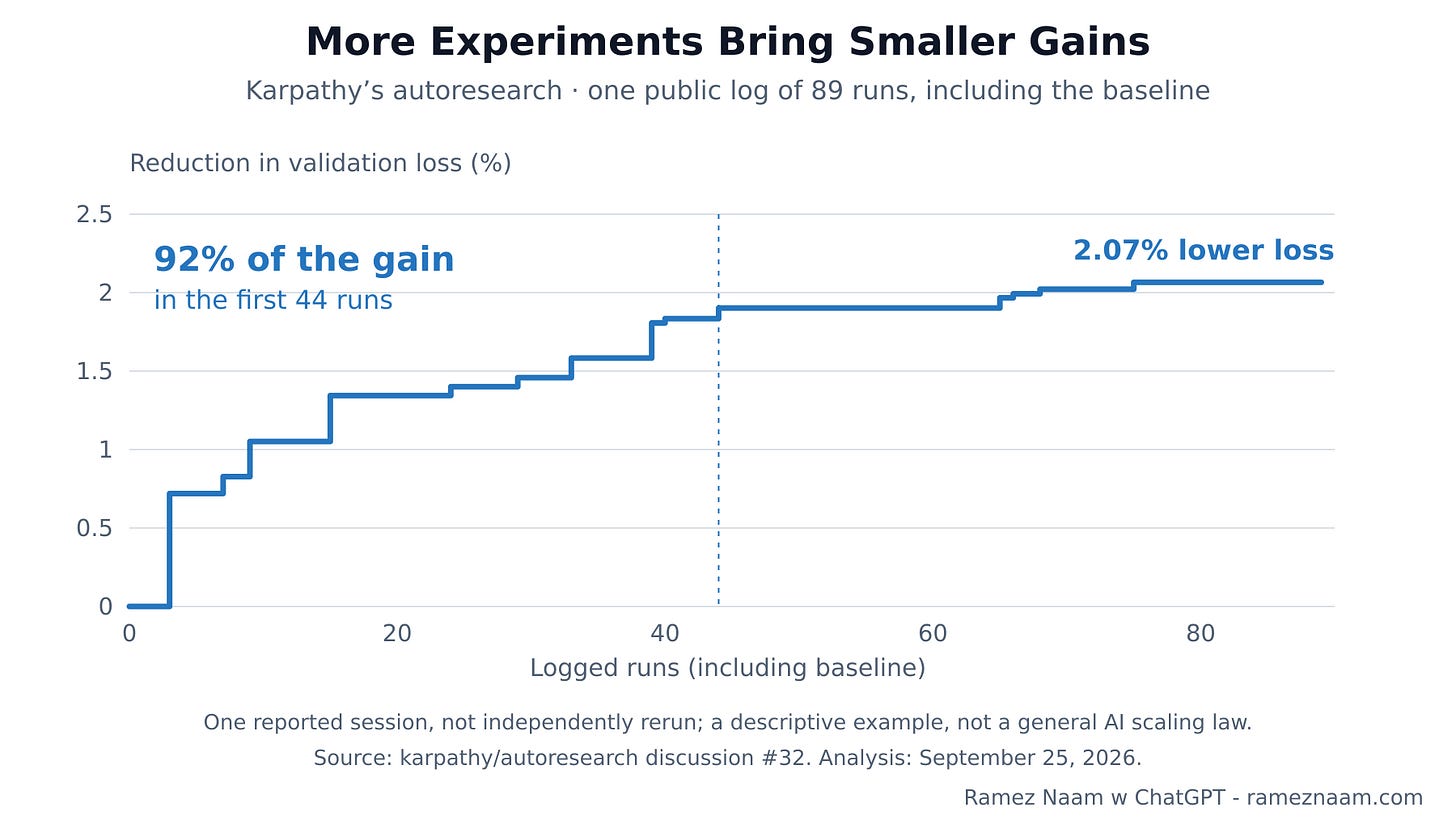
- Karpathy 的 autoresearch(teacher agent 改 student 模型的训练代码):一次公开运行 7.5 小时跑了 89 个实验,92% 的增益在前 44 次实验就到账了——先快后慢的经典曲线。这就是"把人从回路里拿掉,收益递减还在"的活标本。
更深的一层担忧:AI 擅长增量想法,不擅长概念突破。Anthropic 对 Opus 5.5 的描述很不客气——"主要测试增量想法、偏好不那么雄心勃勃的假设,在生物学练习中 defer 已发表文献、难以提出新想法"。METR 的诊断是:全自动 AI 研发还需要大幅提升远见、预测、自建反馈回路——也就是研究员所谓的"判断力"(judgement)和"品味"(taste)。而人类的数据宝库里,增量工作的样本远多于突破的样本——novelty 可能天然难学。
#9. 什么情况会推翻这篇文章
Naam 明确列出了改判条件,这部分同样值得认真读:
- 软件+硬件+经济三环合流:Tom Davidson、Basil Halperin、Thomas Houlden、Anton Korinek 的模型把三个回路耦在一起——AI 设计更好的芯片、芯片支撑更强的 AI、经济增长反哺投资。单个回路不够强时,组合回路可能过门槛。Naam 承认这是他见过最有说服力的综合框架,但保留两点怀疑:(a) 其中心校准假设"全自动软件研究恰好达到门槛",与实测的 2–3% 相差太远,跳跃太大;(b) 芯片从设计到部署的物理延迟(数年)没有显式建入。
- Transformer 级别的概念突破(2017 年那种量级)——一旦出现,所有外推作废。
- 更好的研究员少做实验、单实验信息量更大——少数好想法胜过一座山的例行运行。
另外,收益递减不是新东西:Cortes 等人 1993 年就在拟合机器学习的幂律缩放曲线。递减与 LLM、深度学习无关,它和机器学习本身一样老。除非看到证据表明出现了没有这些抑制因素的新范式,否则应该按"收益递减继续存在"来做计划。
#10. 我们需要更多数据
Naam 诚实地承认自己的结论可能是在"少数据 + 想要相信的安慰性结论"上得出的。Elasticity Institute(Cheryl Wu、Arjun Ramani、Basil Halperin 等)的《How to Measure RSI》提出了实验室应该公开的八类数据,其中最关键的两个问题:
- 资源大致不变时,每个新模型增加了多少"有用的研究"?
- 这些研究如何转化为更好的 AI?
——这正是判断回路是否在变强的唯一硬指标。
#11. 我的评估:这篇文章强在哪、弱在哪
强:
- 把一场通常靠氛围和信仰的争论,拉回到可校准的数字上(门槛 15–19% vs 实测 2–3%),并且诚实标注每处不确定性。
- 用 OpenAI 的实验日志替代自评问卷,是方法上的实质进步。
- Type 1–5 分类把"自主性"和"收益递增"两个维度解耦,一句"把人拿掉不等于把收益递减拿掉"值回全文。
- 作者姿态克制:列出了改判条件,欢迎数据打脸。
弱(读的时候要留个心眼):
- ECI 本身是个聚合指数,"每点 ECI 带来多少生产率"这类换算的线性假设未必成立——回路完全可能非线性增强(更好的模型 → 更好的数据/课程 → 超线性回报)。
- 实验次数不是研究质量。1.6 倍实验数若同时质量大增,2–3% 的估计就偏低。
- OpenAI 内部任务 vs METR 基准不是同类比较(内部任务可能本来就难、且"无人工干预"口径更苛刻),16×/44× 的落差方向可信、倍数存疑。
- 单一时间点的 1.6× 是水平(level)不是斜率(slope)——用它校准回路强度隐含了很强的稳态假设。
- 评论区一位 R1 老研究员的补充值得记下:智力进步本质上是指数困难的,进步是时间积分努力的对数——但"我们忘了哥德尔"这句话本身也是一种不可证伪的修辞。
总评:这不是"AI 不行",恰恰相反——Naam 预期 AI 以几乎所有其他技术标准看都"快得不可思议"地继续进步,窄域超人会在可验证领域持续涌现。他质疑的只是一个具体的强主张:软件回路自身强到足以失控。区别在于:进步的引擎是芯片、资本和数据(外加 AI 这个越来越不可或缺的润滑剂),还是一个自我点燃的正反馈。
#12. 对我们研究方向的启发
给关注 LLM Agent、长轨迹 RL、基础模型训练的同学划几条重点:
- 可验证域是 RL 的主场,而且配方已被验证:Navier–Stokes 的背后是"预训练模型 + 大规模 RL",不是 agent 编排。形式数学/代码/安全攻防这类 verifier 即 spec 的领域,会最先看到超人能力——这是设计 research agenda 时最值得押注的结构性事实。
- Agent 同质化是实证问题,不是玄学:2 个 AI ≈ 1 个人的多样性递减,直接指向探索机制、多样性正则、异构 agent 群体的研究空间——对 multi-agent RL 和 credit assignment 都是核心约束。
- "判断力/品味"是被点名的缺失组件:METR 说全自动研究需要 foresight、prediction、自建反馈回路。这几乎就是 model-based RL / world model 要提供的东西——AI 需要在没有外部验证器的地方自己造验证器。
- 对"直接在超长轨迹上做 RL"的怀疑多了一份实证支撑:Karpathy autoresearch 的"92% 增益来自前 44 次实验"提示,无判断力的试错收敛极快、然后平台化——真正的增益在实验选择的质量,不在数量。这与"与其堆轨迹,不如提升单步信息量"的直觉一致。
- 跟踪这套指标体系:METR task horizon、ECI/AECI、CoBench、实验节奏/生产率换算、Elasticity Institute 的八项提议——这是目前观察"回路强度"最成体系的仪表盘。
#附:名词速查
| 术语 | 人话解释 |
|---|---|
| RSI | AI 参与/主导"造更好的 AI",回路闭环 |
| FOOM / fast takeoff | 回路失控,能力在数天~数月内爆炸到 ASI |
| ECI / AECI | Epoch / Anthropic 的 AI 综合能力指数,越高越强 |
| METR task horizon | 模型以 80% 成功率完成的任务时长(人类工时计) |
| 门槛(15–19%) | 每点 ECI 需带来的生产率提升,回路才能自我维持 |
| Eroom's Law | 制药研发:每款新药成本约 9 年翻倍(Moore 反写) |
| 摘苹果模型 | 低垂果实被摘光后,进步需要更强的"摘果机" |
| CoBench | Anthropic 用历史 AI 研发问题构建的研究能力基准 |
一句话收尾:智能爆炸目前不在数据里——数据里是一个每转一圈都变弱一点的回路,和一群仍在狂奔的人。保持相信爆炸可以,但请像 Naam 一样,给出能被数据推翻的理由。