#Unslopping AI(RL-XAR)详解:怎么让 AI 不再写“AI 味”的文字
原文:Towards RL for Superhuman Text: Unslopping AI(RAM @ Meta AI 博客,2026 年 9 月,Jason Weston / Ilia Kulikov / Swarnadeep Saha;完整技术报告即将上 arXiv)
链接:https://facebookresearch.github.io/RAM/blogs/unslop/
#0. 一句话核心结论
RL 让 AI 在“可验证任务”(数学、代码)上超过了人类,但在“不可验证任务”(好文章)上还是菜——这篇文章的核心贡献是把“什么叫写得好”变成一个可学习、可优化的评分体系(rubric),从而把写作也变成了 RL 能啃的“可验证”问题。方法叫 RL-XAR(Reinforcement Learning from eXpert-Aligned Rubrics),直觉非常像 GAN:找一个“裁判”专门挑 AI 文字的毛病,训练到挑不出来为止。
#1. 问题是什么:为什么 AI 写的东西有“AI 味”
先说人话版的病根。
“AI slop”:模型生成的文字流畅、工整、面面俱到,但读起来就是平庸——没有取舍、没有节奏、没有“作者的判断力”。
为什么会这样?预训练的目标是“预测下一个最可能的 token”。训练语料从论坛灌水到专家散文什么质量都有,最大似然训练的结果就是续写什么质量的上下文,就输出什么质量的续写——目标函数里没有任何一项在把生成往“专家水平”推。给你一段平庸的开头,模型自然顺着平庸写下去。
那 RLHF 为什么救不了?RLHF 是“奖励模型说了算”,但奖励模型是从标注者的排序偏好里训出来的。问题在于:标注者自己大多不是专家作家,他们的偏好天花板就是模型的天花板。你最想要的那种“专家级、甚至超人的写作质量”,恰恰是普通标注者认证不了的质量。这就形成一个死结:
好的写作奖励 ← 需要专家级的判断 ← 专家判断无法规模化标注。
这篇文章的全部工作就是解开这个死结:不需要专家来当标注者,只需要专家“曾经写过的作品”——它们在论文库、文学奖书单、Wikipedia 精选条目里已经存在了。
#2. 第一步:先证明问题的存在——LLM judge 根本分不清谁写得好
在做任何训练之前,作者先做了一个扎心的诊断实验。
任务设定:给模型一篇高质量论文、挖掉一个章节(摘要/引言/相关工作/结论),让模型补写这个章节,字数对齐人类原文。人类被挖掉的原文就是天然的“专家参考答案”——这个任务可以从已发表文献里无限量自动生成,完美。
诊断结果:让 Opus-4.8 和 GPT-5.6 互为作者和裁判(交叉评测):
| 评判方式 | 结果 |
|---|---|
| 直接 pairwise 裁判(“哪个版本更好?”) | 裁判偏爱模型,63.5%–84.6% 的情况把 AI 写的排在人类专家前面 |
| 标准 rubric 裁判(用 GPT-5.6 生成的常规评分规则) | 更极端:100% 选模型 |
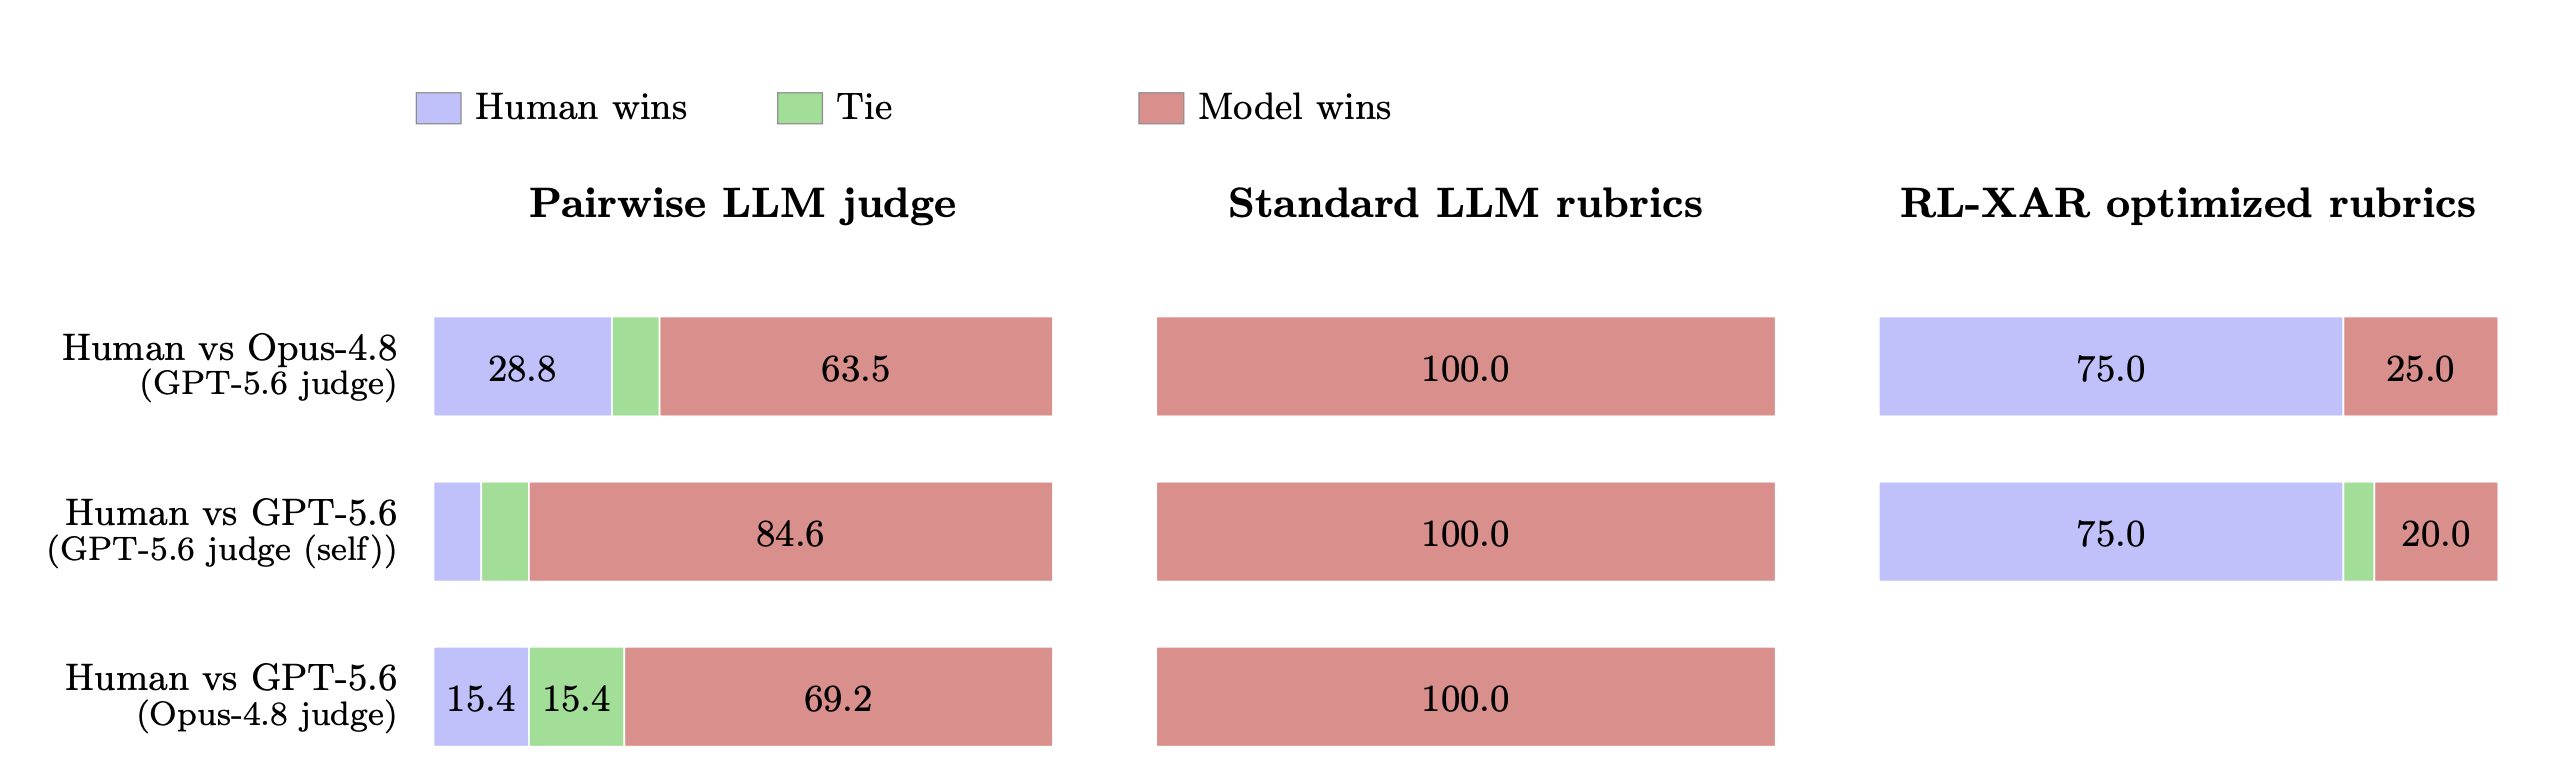
这个诊断的分量很重:如果你用 LLM judge 当奖励信号去训练,你训练出来的就是更多 slop。AI 味的文字在 AI 裁判眼里就是“更好的”——因为裁判自己和写作者共享同一套偏差:把“面面俱到”当“全面”、把“流畅模仿”当“深刻”。
这直接解释了过去两年“用 GPT-4 当裁判做写作 RL”收效甚微的原因:不是 RL 不行,是奖励在奖励错误的东西。
#3. 第二步:RL-XAR 的方法——让 rubric“学会”偏心人类
方法的三步:
- 收集专家文本:拿到大量远超平均水准的人类作品(顶级论文、普利策/诺奖小说、Wikipedia 精选条目),切成“上下文 + 续写”;
- 学习“偏心人类”的 rubric:让模型对同样的上下文生成竞争性续写(预期是 slop),这样就有了“人类应该得分更高”的学习对——然后用这些对去优化一个评分规则生成器,目标是最大化人类得分与模型得分的差(gap);
- 用学到的 rubric 做 RL:奖励信号 = rubric 打的分。
然后 1→2→3 循环迭代,直到元优化再也找不出人类和当前模型的差距——即模型已经好到裁判挑不出它和专家的区别。
作者自己点破:这个结构和 GAN 一模一样。rubric 生成器 = 判别器(专挑当前模型的毛病),被训练的写作模型 = 生成器(把毛病一个个修掉)。区别在于判别器不是神经网络而是一个“元提示词 + LLM”,对抗发生在提示词空间。
#rubric 怎么“学”:元提示词优化
具体实现朴素得惊人:
- 有一个初始元提示词(meta-prompt):给定上下文,让 LLM 生成针对这段续写的评分规则;
- 元提示词的质量可以用“人类-模型 gap”在训练集上打分——gap 本身就是元提示词的适应度函数;
- 优化循环:给优化器 LLM(Kimi-K2.6)看当前元提示词、它达成的 gap、以及具体失败的例子,让它提一版修改,要求“为真实质量而改进,不是找表面特征”(for genuine-quality reasons, not superficial tells);
- 关键约束:元提示词长度有上限,优化器必须合并、精炼标准,不能无限堆条款——这防止 rubric 变成一张过拟合的检查清单。
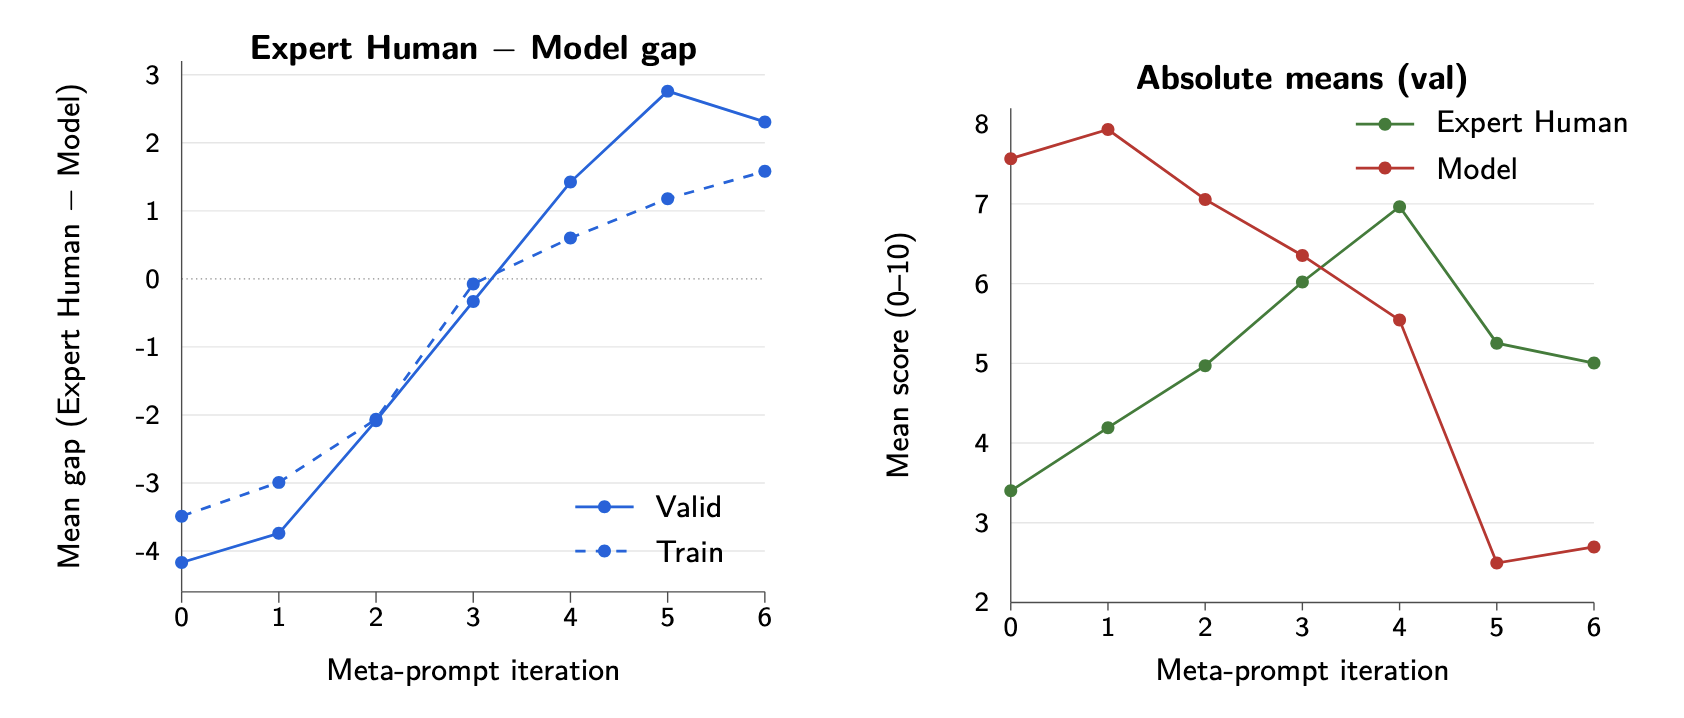
小样本可行性实验(52 个论文-章节例子)里,gap 从 -4.2(裁判偏爱模型)一路爬到 +2.76(裁判偏爱人类),第 4 轮过零,且验证集 gap 跟随训练集——没有过拟合。
#学到的 rubric 到底学到了什么(这部分最有洞察)
初始 rubric 生成出来的都是论文内容覆盖清单:这个章节必须提到哪些 claim、方法、结果——结果变成一张长清单,奖励在章节里塞进一篇“迷你论文”。这种标准奖励流畅的模仿(把全文内容复述一遍),反而惩罚人类的克制取舍(专家故意省略的东西被扣分)。
经过优化,rubric 收敛到一套反直觉但极符合写作直觉的标准:
- 章节本位(sectional ownership):一个 introduction 就该是 introduction,不是全论文缩微版;
- 克制的选材(disciplined selection):省略是能力,不是缺陷;
- 经济性(economy)和精确的在范围内的细节,而不是覆盖广度。
换句话说,元优化逼着 rubric 把“写作教学的常识”重新发现了一遍——而这套标准恰好全是人类编辑会说的东西。这侧面证明 gap 优化捕捉的是真实的质量结构,不是作弊特征(cheating on superficial tells 至少被明确地对抗了)。
#4. 第三步:主实验——三个领域的结果
统一配方:Qwen3.5-27B 做被训练的写作者,Qwen3.8-2.4T-A95B 做训练时的 rubric 打分裁判(跨家族避免自评偏差),Kimi-K2.6 做元优化器,GRPO 做 RL。评测时换 GPT-5.6 当裁判(训练和评测用不同裁判),人类得分归一化为 10。
#4.1 论文章节写作(效果最好)
- 数据:S2ORC 的 561 篇 CS 论文,轮流挖掉四个章节 → 2,243 个训练样本,90 篇论文留验证;
- 跑三轮 RL-XAR 外循环;
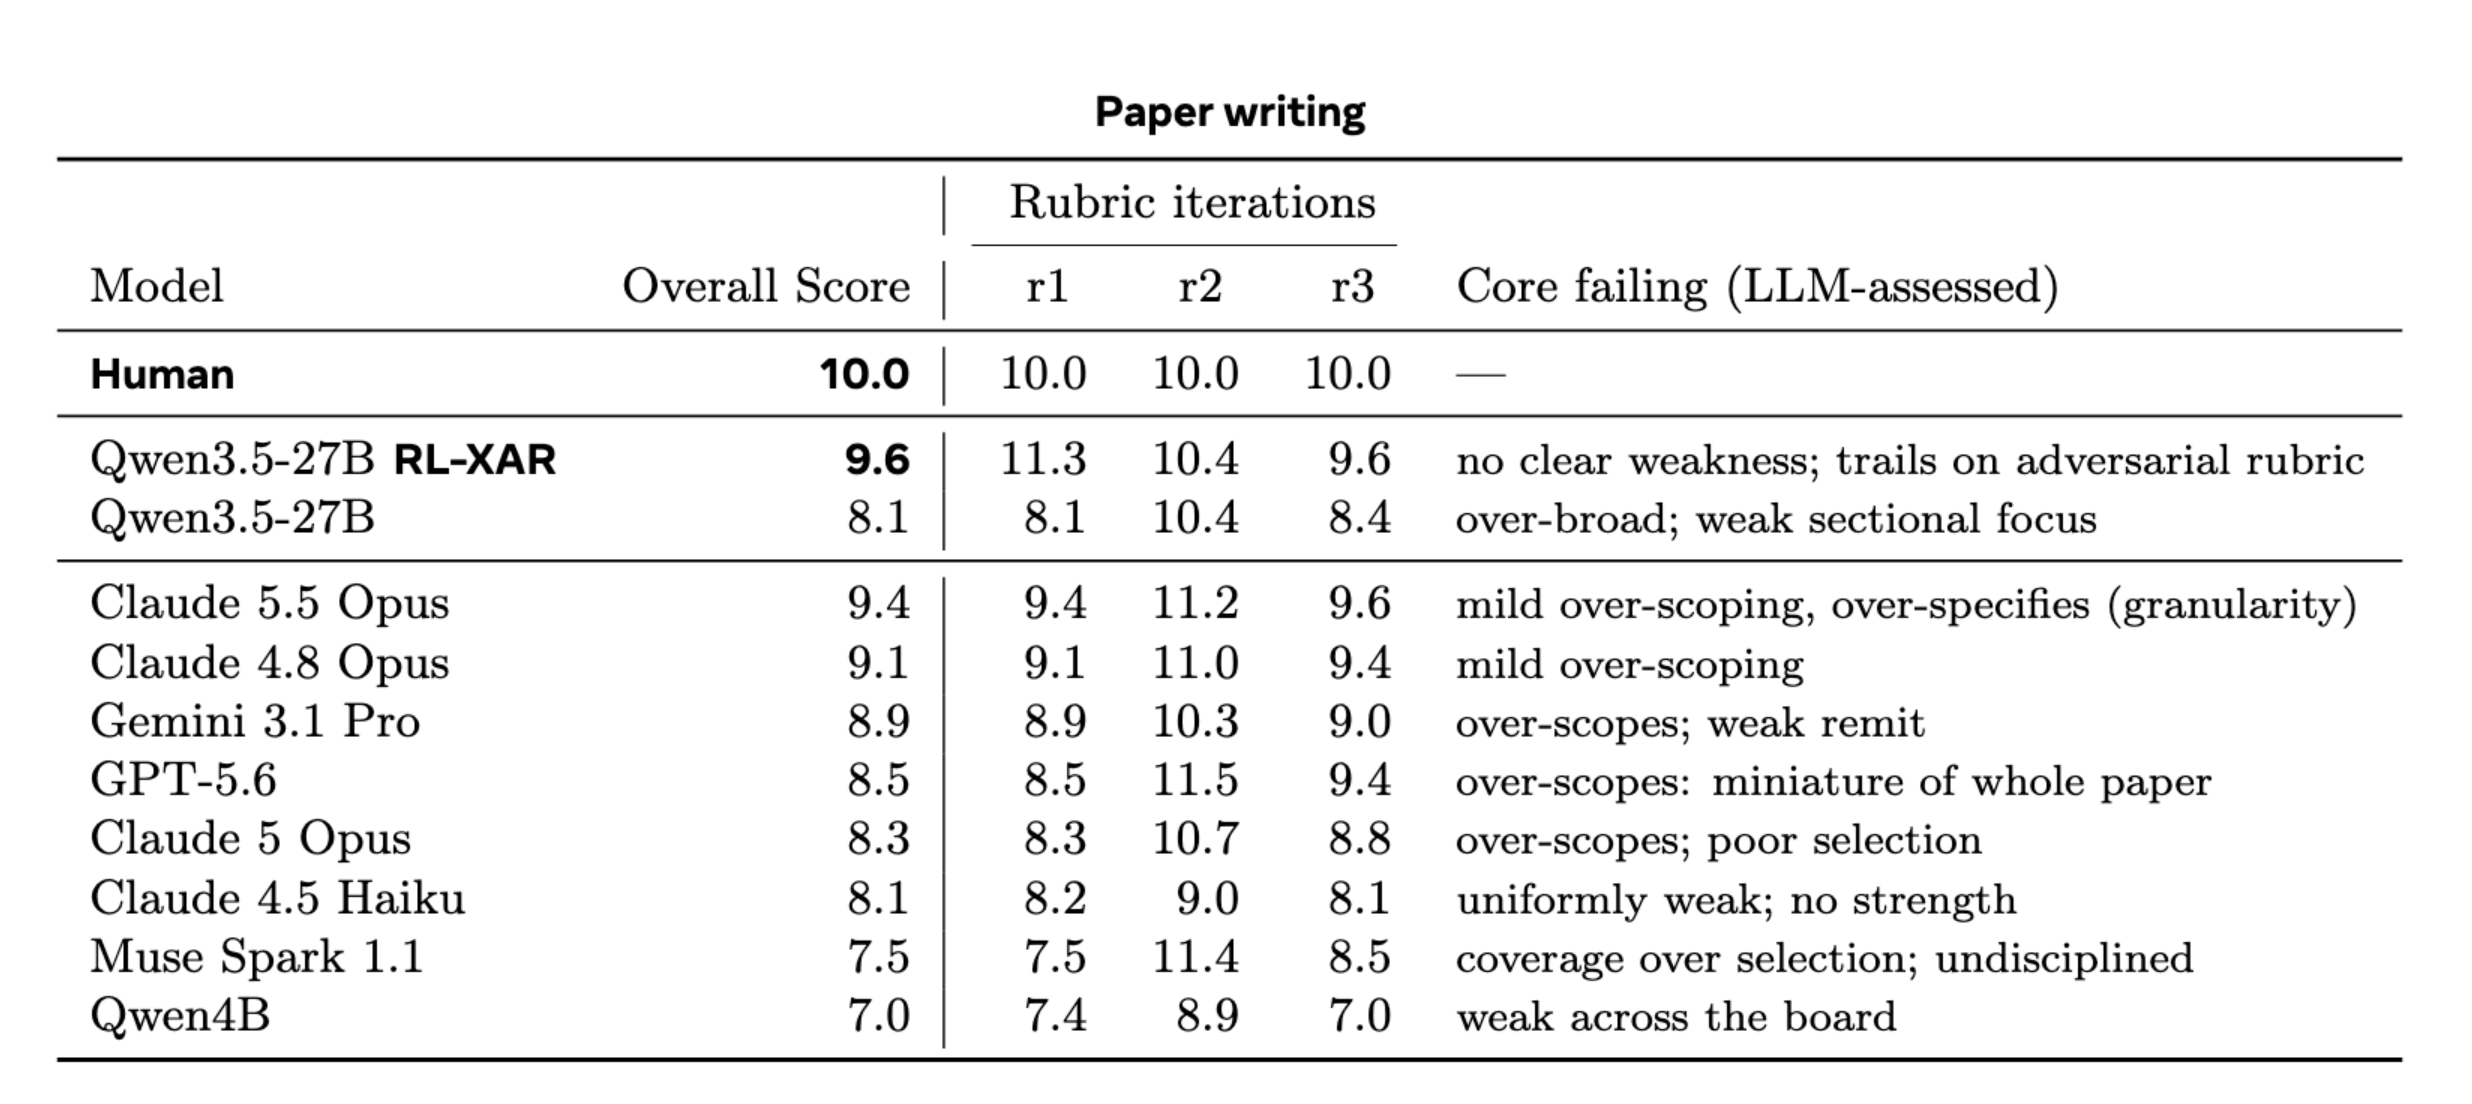
- 评测防作弊设计:在一个 rubric 上训出来的模型可能只学会了讨好那张 rubric,所以每个写作者要在三轮 rubric 上全测,按最低分排名——不许挑对自己有利的尺子;
- 结果:RL-XAR 的 27B 模型最差 rubric 得分 9.60(人类=10),超过所有参比的前沿模型(包括 GPT-5.6、Opus-4.8 本尊);
- 盲测专家评估:论文作者本人(对自己论文显然是专家)盲选 RL-XAR vs 基线 Qwen3.5-27B,16:2,89% 胜率。失败模式分析很具体:基线爱写“迷你论文”、塞不必要的数字细节;RL-XAR 也远不完美,作者明说更好的 rubric 和裁判还能挑出更多毛病。
#4.2 小说续写(效果同样大)
- 数据:Project Gutenberg 公版书,按“普利策/诺奖作者”这个外部人类资质筛选,偏向冷门作品(防记忆),再加 n-gram 去污染(温度 0 探测重现 >5% 的 13-gram、或连续 20 词 verbatim 的样本直接丢弃)——防记忆的严谨程度值得学习;
- 单轮 RL-XAR:2.8 → 8.2,所有写作者里第一名(第二名 Claude 5 Opus 6.8);
- 盲测人类评估:19:1,95% 胜率。基线的典型病症:陈词滥调的比喻(“空气像一块温布悬在桌上”)、不跟随原作者文风。
#4.3 Wikipedia 章节写作(失败案例,同样重要)
- 只给标题 + 章节标题,从零写正文;
- 2.7 → 4.0:提升很小,且远低于人类和前沿模型(GPT-5.6 是 7.9);
- 作者的诊断:三个任务里最难,部分因为训练时用的 Qwen3.8 裁判太弱,当不了这个任务的 grader。
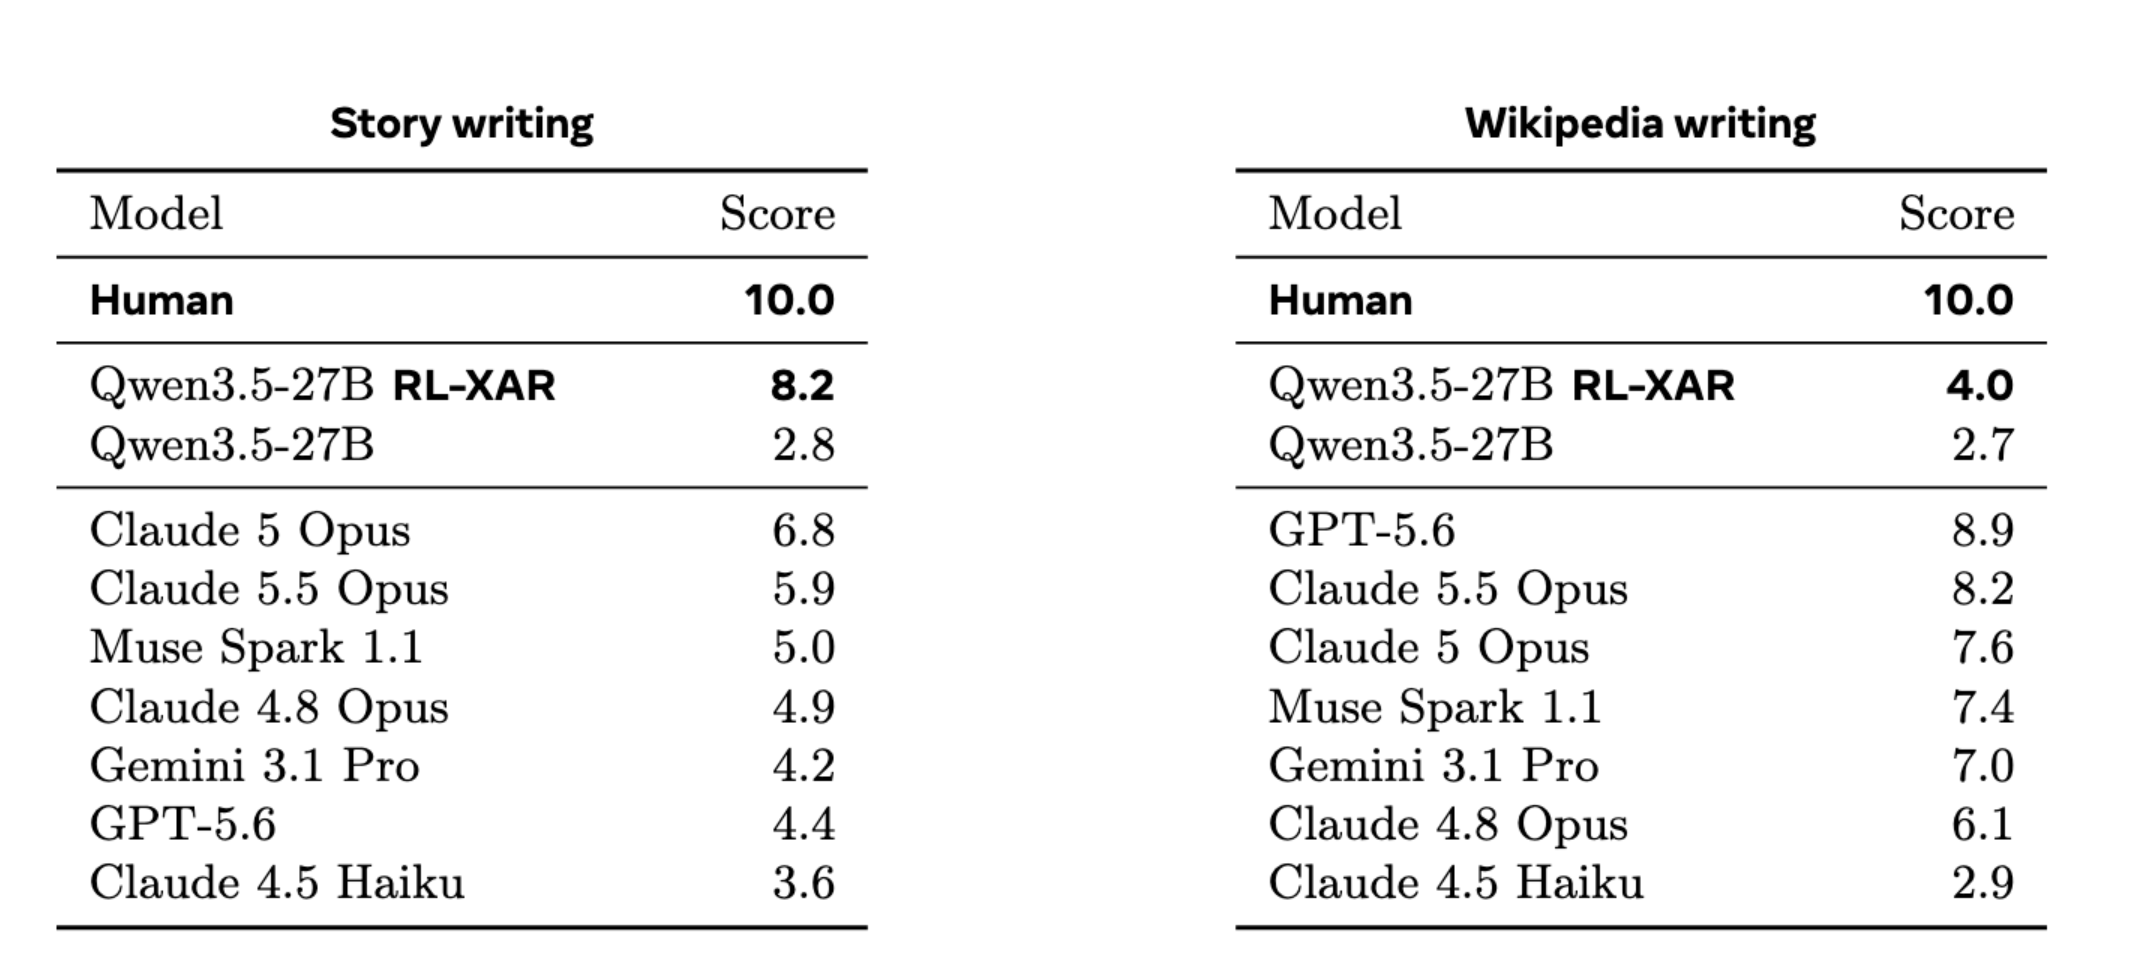
三个领域放在一起的结论不是“RL-XAR 万能”,而是:配方里每一环(专家数据质量、裁判强度、优化器强度、任务本身难度)都可能是瓶颈——论文后面逐一做了消融。
#5. 消融与分析:哪些组件真的重要
(1)裁判的强度是硬门槛。用不同裁判对同一套 XAR rubric 打分:故事和 Wikipedia 任务上,只有最弱的 Qwen3.5-27B 裁判把模型排在人类之上(gap 为负),强裁判都是人类优先。弱裁判不是“严格”,是根本看不见差距。
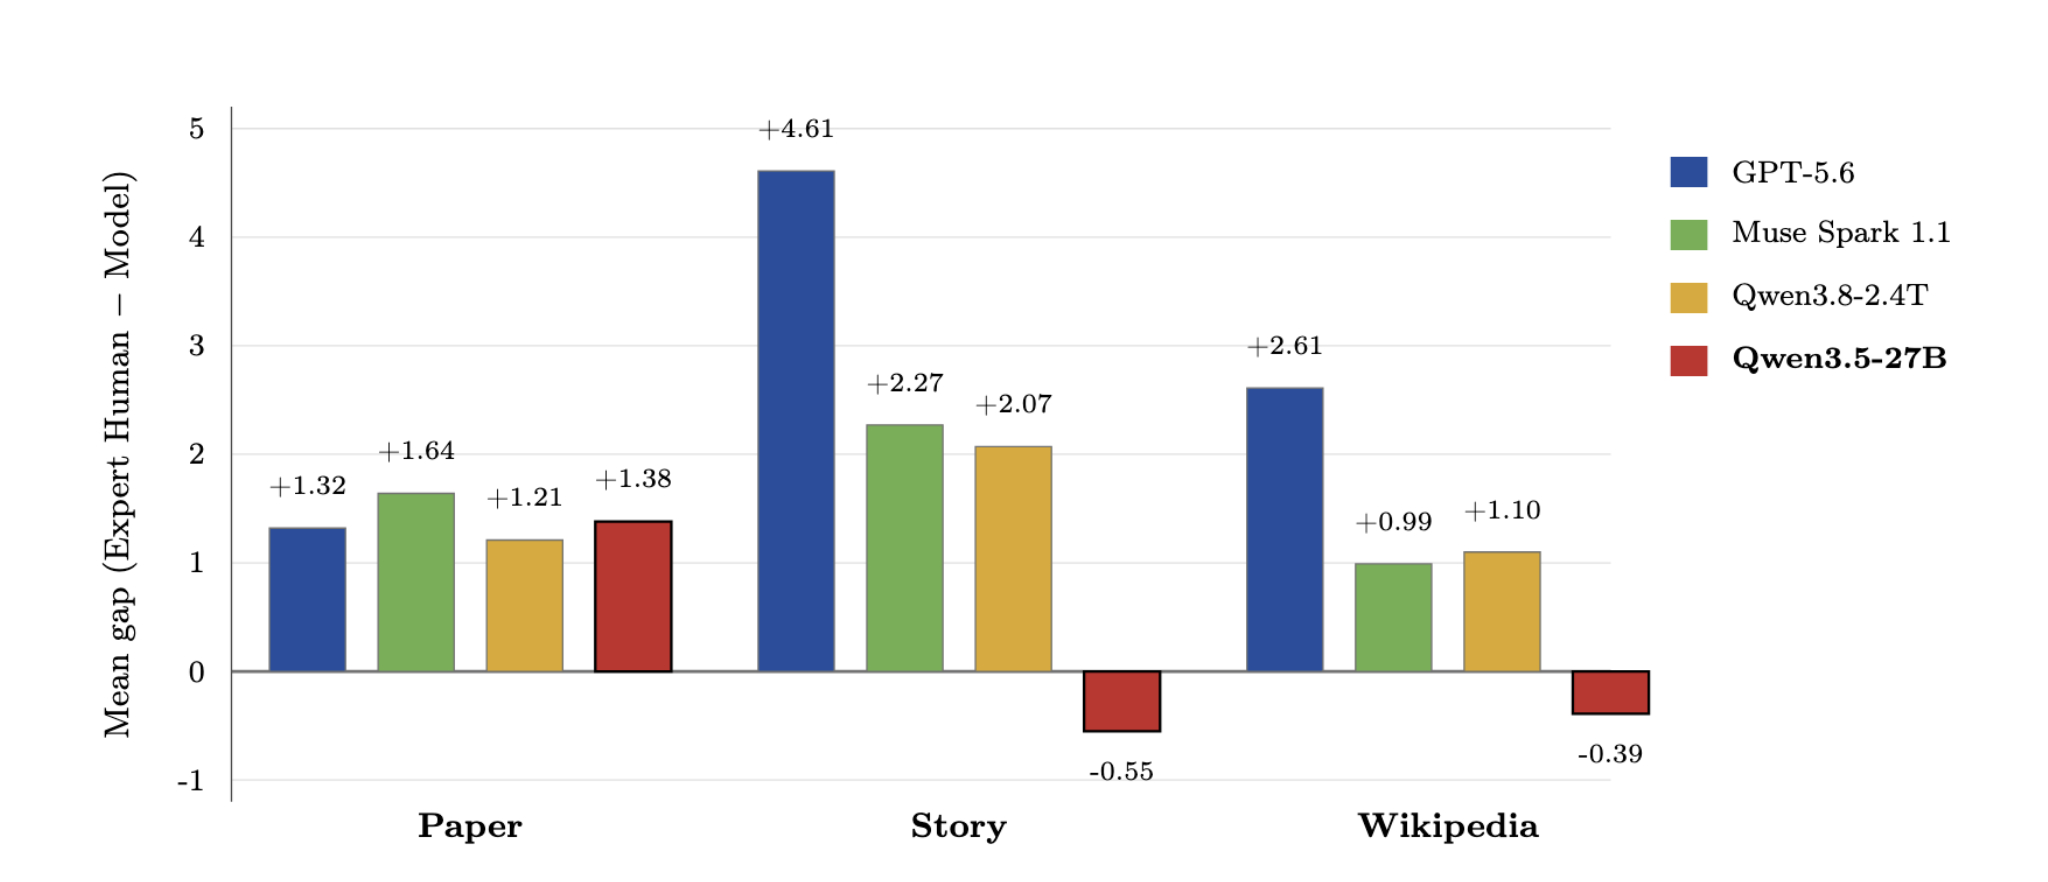
(2)元优化器的强度也是门槛。Kimi-K2.6 和 Opus 5 都能找到正 gap,Muse Spark 1.1 挣扎。顺带:作者试了 GEPA(DSPy 那套提示词优化),没有比朴素迭代修改更好——提示词优化器选哪个目前还不是决定性因素。
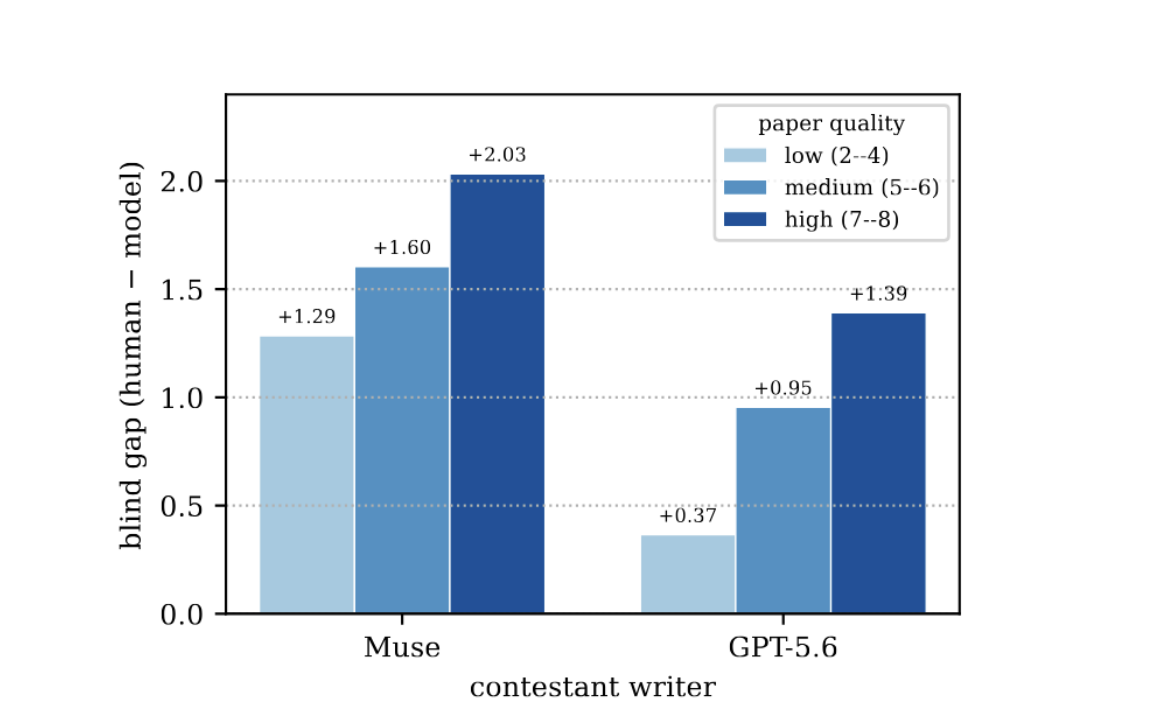
(3)专家样本的质量决定一切。把人类参考换成低/中/高质量论文分别测 gap:高质量人类 gap +1.39、中等 +0.95、低质量只有 +0.37。用平庸的人类文本当“专家参考”,整个方法直接失效——rubric 没有可学的差距。而且这个单调关系本身是 rubric 在测量真实质量的旁证。
(4)rubric 可跨裁判泛化。为 GPT-5.6 优化的 rubric 拿给 Muse Spark 1.1 当裁判照样人类优先——只要两个裁判都够强,rubric 学到的是“质量的客观结构”而不是某个裁判的怪癖。
(5)迭代是必要的。只训一轮,模型在第 1 轮 rubric 上得分 11.0 的代价是第 2 轮 rubric 上只有 7.0(低于起点 10.4)——单一 rubric 会被 Goodhart 化,模型学会讨好一张尺子。迭代到第二轮,第 2 轮 rubric 恢复基线水平,其他两轮也保持高分。这和“评测取三轮最低分”是同一逻辑的两面。
(6)长度约束不能省。不限制字数时模型会写 2–3 倍长度刷分(更长的“面面俱到”在 rubric 上占便宜)。副作用是强模型会花大量 CoT 在数字数上——一个真实又好笑的工程细节。
(7)在线版(初探)。rubric 生成器本身也用 GRPO 联训(reward = 归一化 gap),写作模型和 rubric 同时对抗训练——故事任务上 2.8 → 6.0,尚不如交替式的 8.2,但方向可行。
#6. 我的解读:这篇工作的分量和边界
分量在于:它给“不可验证任务的 RL”提供了一个可复制的模板。过去两年 RLVR(RL with Verifiable Rewards)的成功全部建立在可程序化判定的任务上(数学答案对错、单测通过)。写作、审美、品味这些“人类最在乎但无法形式化”的能力一直被排除在 RL 红利之外。RL-XAR 的模板是:
专家作品天然存在 → “人类应该赢过模型”构成免费的监督信号 → 用元优化把这个信号压进 rubric → rubric 变成可验证奖励。
这个模板显然不限于写作:任何“存在公认高质量人类产出、且当前模型明显更弱”的领域(设计、代码风格、数学证明的优雅度)理论上都能套。
几个值得认真对待的边界:
- 循环论证的风险。rubric 是“被优化到偏心人类”的,然后人类归一化分数用这套 rubric 报告——裁判和尺子同源。作者用交叉家族裁判 + 专家盲测 + 质量单调性旁证来堵这个洞,堵得算认真(16:2 和 19:1 的盲测是全文最硬的证据),但“rubric 分数”这个指标本身仍要打折读。
- Wikipedia 的失败提醒:这个方法的下限由最弱一环决定。裁判弱 → gap 学不出来 → 奖励失效。而“裁判够不够强”目前只能试出来。
- “直到挑不出差距”的收敛点未必是超人水平。rubric 是从“人类 vs 模型”的对比里学出来的,它的上限是人类专家的可辨识特征。真正的“超人写作”(人类写不出来的好)在这套框架里没有正例可学——这是它和 GAN 类比真正的深层差异:判别器见过的人类样本就是它的全部世界观。
- 27B 模型 + 前沿裁判的组合说明:这个范式里智能的瓶颈在裁判,不在生成器。也说明这个方法对“开源小模型 + 闭源大裁判 API”的工程组合非常友好。
和几条相关研究线的连接:
- LLM-as-judge 的偏差研究:这篇等于给“judge 偏好 AI 文风”补了一个存在性证明(pairwise 和常规 rubric 双双失守),并给出了第一种系统性的修复方案——不是修 judge,而是学一个让 judge 站到人类这边的评分标准;
- 自训练/STaR 一族:都是“模型自身产出 + 外部锚点信号”的闭环,但 STaR 的锚点是可验证答案,RL-XAR 把锚点扩展到了“专家文本的存在性”本身;
- 对 wenjun 关注方向的启发:agent 领域同样有一大堆“质量可感知、奖励难形式化”的产出(轨迹规划得优雅吗?中间步骤该省略吗?)。“专家轨迹 vs 模型轨迹”的 gap 元优化完全可以搬到 agent 轨迹评估上——和之前调研的 harness 轨迹蒸馏(把运行时学到的知识回流权重)是一枚硬币的两面:那边缺可靠的评估信号,这边刚好提供了一个造信号的配方。
#7. 读后速查卡
| 项目 | 内容 |
|---|---|
| 方法名 | RL-XAR(Reinforcement Learning from eXpert-Aligned Rubrics) |
| 作者 | Jason Weston, Ilia Kulikov, Swarnadeep Saha(Meta FAIR / RAM) |
| 核心三步 | 专家文本 → 元优化“偏心人类”的 rubric → 对 rubric 做 RL,循环至 gap 消失 |
| 类比 | GAN:rubric 生成器 = 判别器,写作者 = 生成器,对抗发生在提示词空间 |
| 主结果 | 论文章节:27B 超 GPT-5.6/Opus-4.8,专家盲测 89% 胜率;小说:+5.4 分登顶,盲测 95% 胜率;Wikipedia:仅小幅提升(裁判太弱) |
| 关键消融 | 裁判强度、优化器强度、专家样本质量都是硬门槛;rubric 可跨强裁判泛化;必须迭代防 Goodhart |
| 局限 | 循环论证风险、上限受“人类可辨识特征”约束、下限由最弱组件决定 |
来源与引用:博客原文 Weston, Kulikov & Saha, "Towards RL for Superhuman Text: Unslopping AI", 2026(@article{weston2026unslop}),图片取自原文页面。本文为独立详解,观点与解读部分不代表原作者。